

事件与一致性
事件与一致性
对象字节在 MinIO,索引在 MySQL。两边没有共享事务,唯一的连接是 object-storage 写出的两条事件:OBJECT_CREATED 与 OBJECT_DELETED。这条事件流保证“至少一次”投递,但不保证顺序,也不保证两份数据收敛。
1. 两份数据与一条事件流
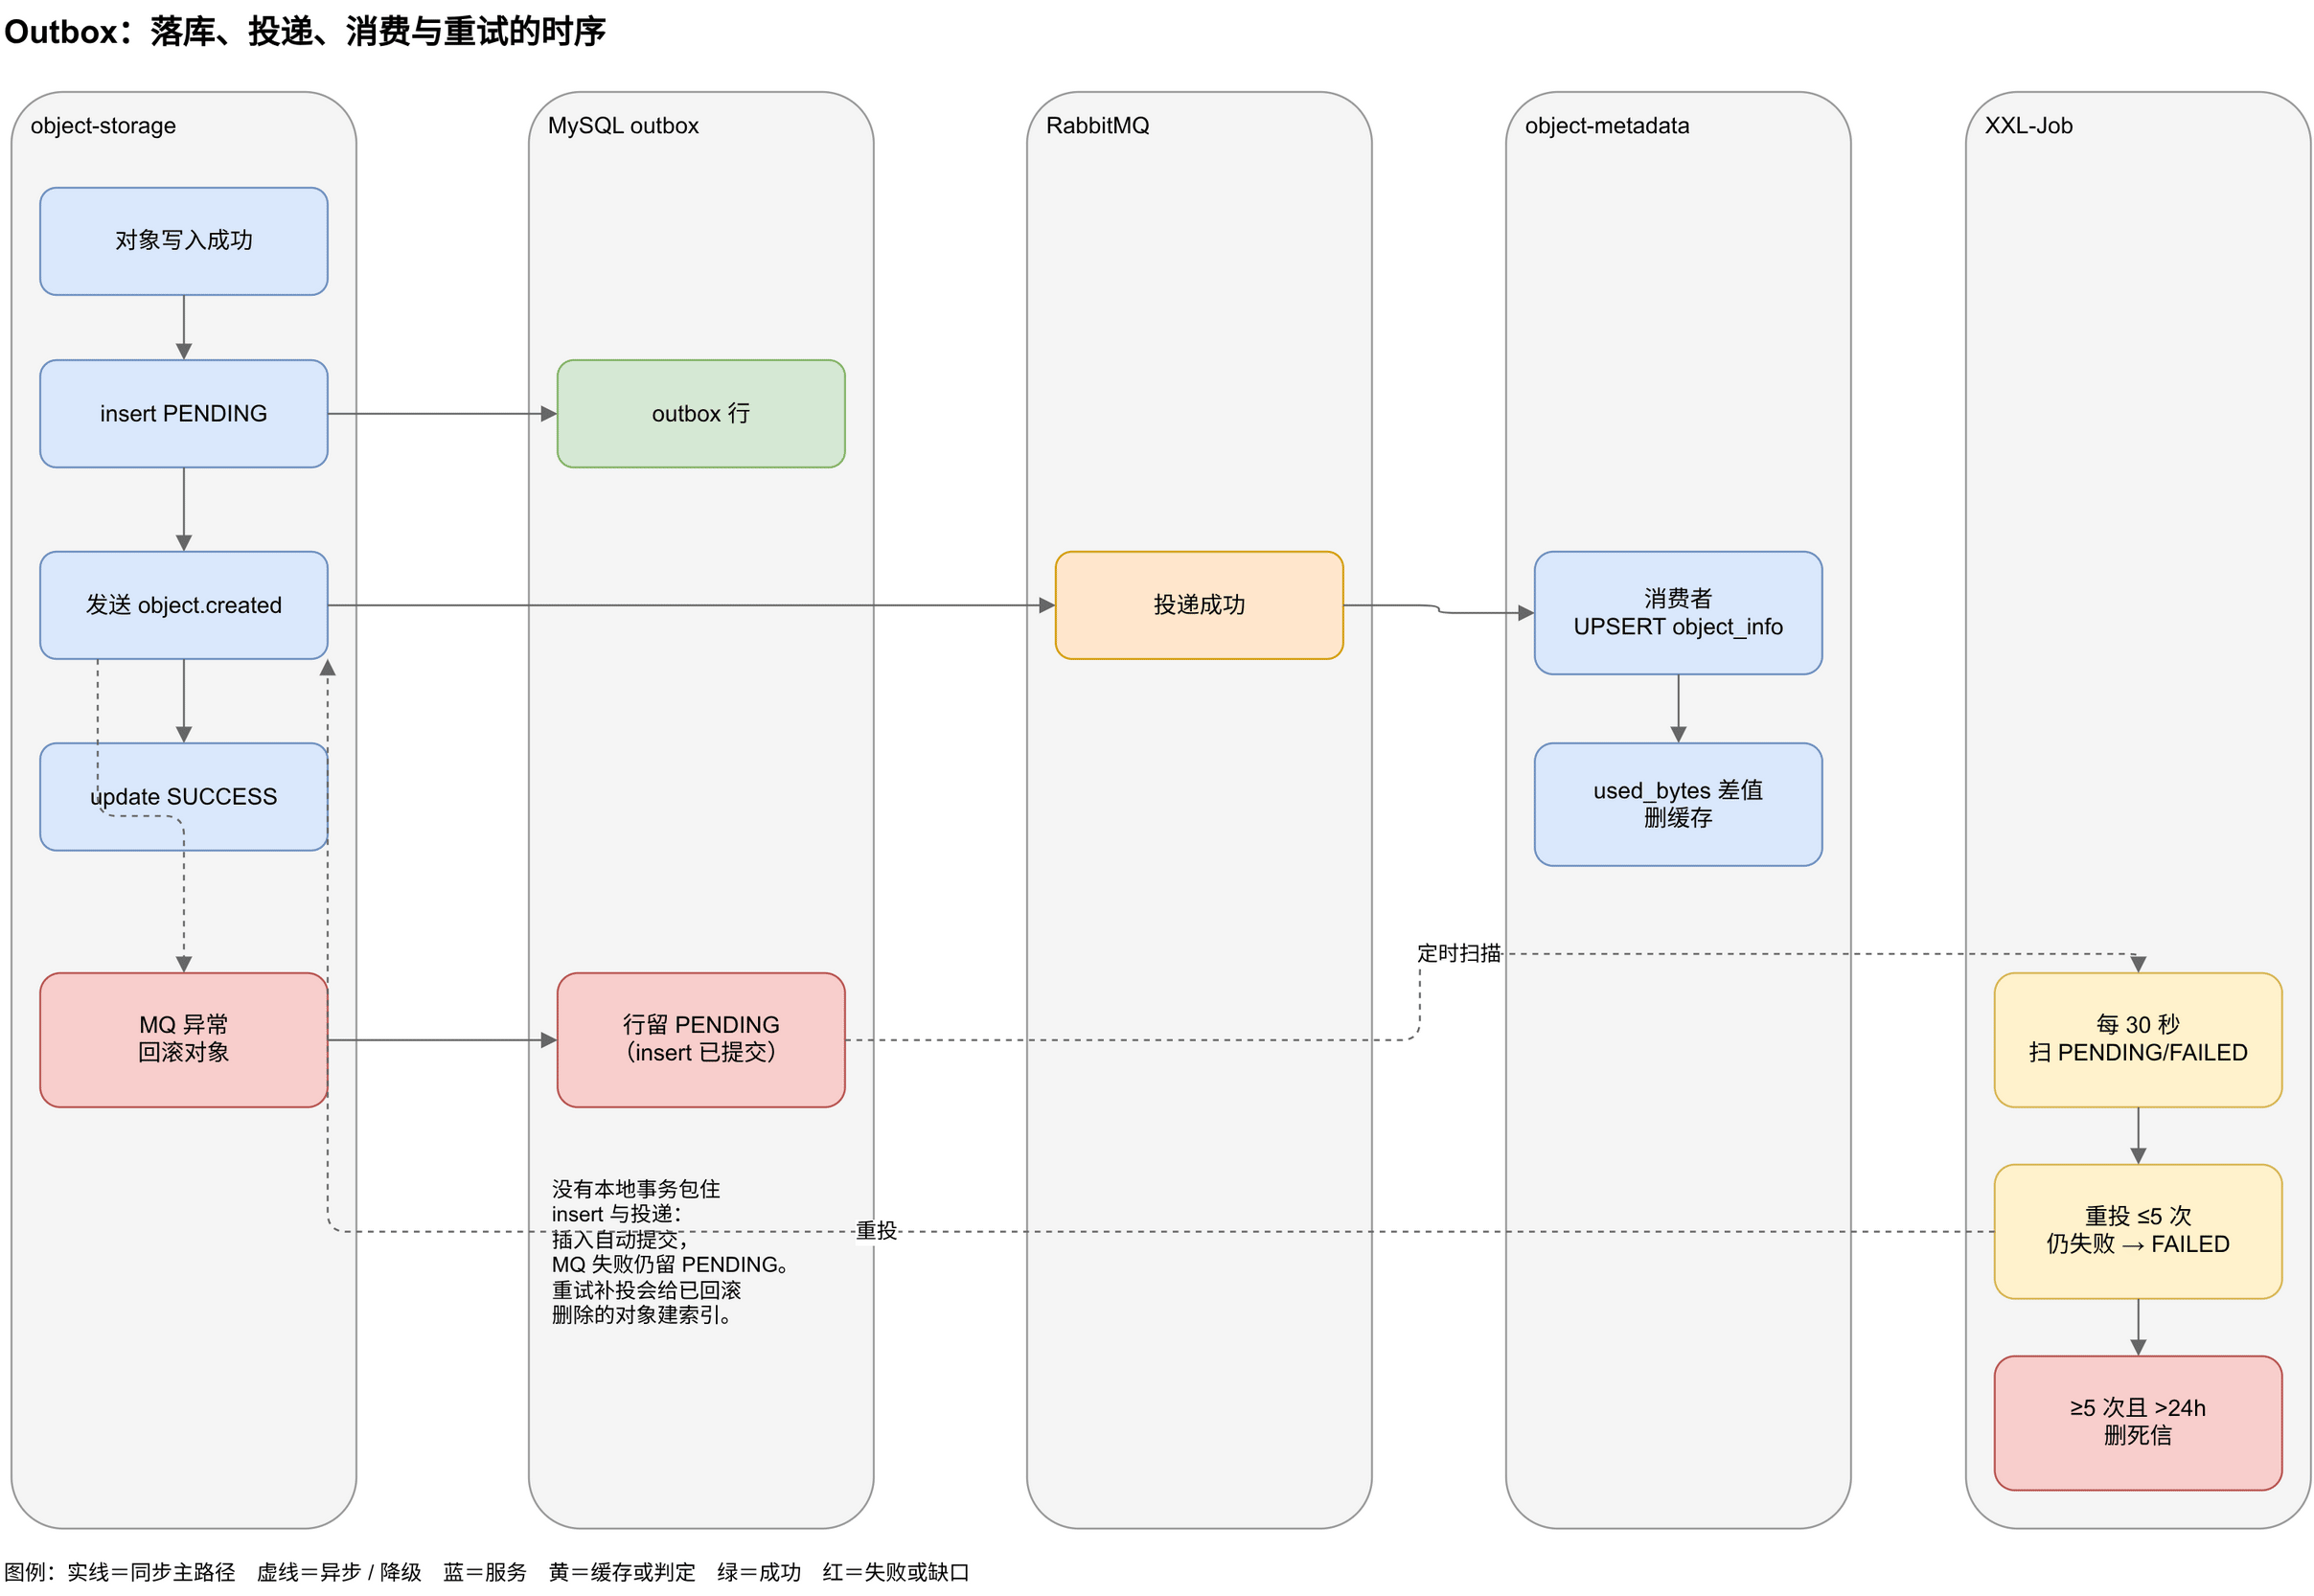
上传成功后,object-storage 在 outbox_table 插入一行 PENDING,再向 Topic Exchange cloud-disk.object 投递:
| 事件 | routing key | 消费者 | 结果 |
|---|---|---|---|
OBJECT_CREATED | object.created | ObjectCreatedConsumer | UPSERT object_info,更新 used_bytes,删缓存 |
OBJECT_DELETED | object.deleted | ObjectDeletedConsumer | 状态改 RECYCLED |
投递成功后同一行改成 SUCCESS;投递抛 AmqpException 时行留在 PENDING,异常继续向上抛,调用方因此回滚刚写的对象。
2. Outbox 表:状态与发送顺序
outbox_table 的字段很少:
| 列 | 用途 |
|---|---|
message_type | OBJECT_CREATED / OBJECT_DELETED |
payload | 事件 JSON |
status | PENDING / SUCCESS / FAILED |
retry_count | 重试次数,初值 0 |
created_at | 插入时间 |
next_retry_at | 失败后写 now + 5min,扫描条件没有用它 |
状态迁移只有三条:
PENDING --发送成功--> SUCCESS
PENDING --发送失败--> PENDING(retry_count 不变)
PENDING/FAILED --重试失败--> FAILED,retry_count + 1
代码里没有 @Transactional 包住“插 outbox + 发 MQ”。MyBatis 的 insert 在无外层事务时自动提交,所以 MQ 失败时那行 PENDING 是真实落库的;调用方回滚对象并不会回滚这行记录。
3. 消费端幂等
两个消费者都带 @Transactional,但幂等不是靠事务实现的,是靠写入语义:
Created。 先按 bucket_id + object_key 查行。
- 不存在:插入新行,
sizeDelta = size。 - 存在:更新字段,
sizeDelta = size - 旧 size。
同一事件重复消费时第二次的 sizeDelta 是 0,used_bytes 不会被加两次。这也是覆盖上传能正确累计的原因:旧 100 字节换成新 300 字节,只加 200。
Deleted。 只有当前状态不是 RECYCLED 才更新。重复消费是空操作。
两个消费者都按 bucketName 查 Bucket。查不到时只打 error 然后 return,消息被正常确认,事件就丢了;没有重试,也没有死信。
4. 对象状态机
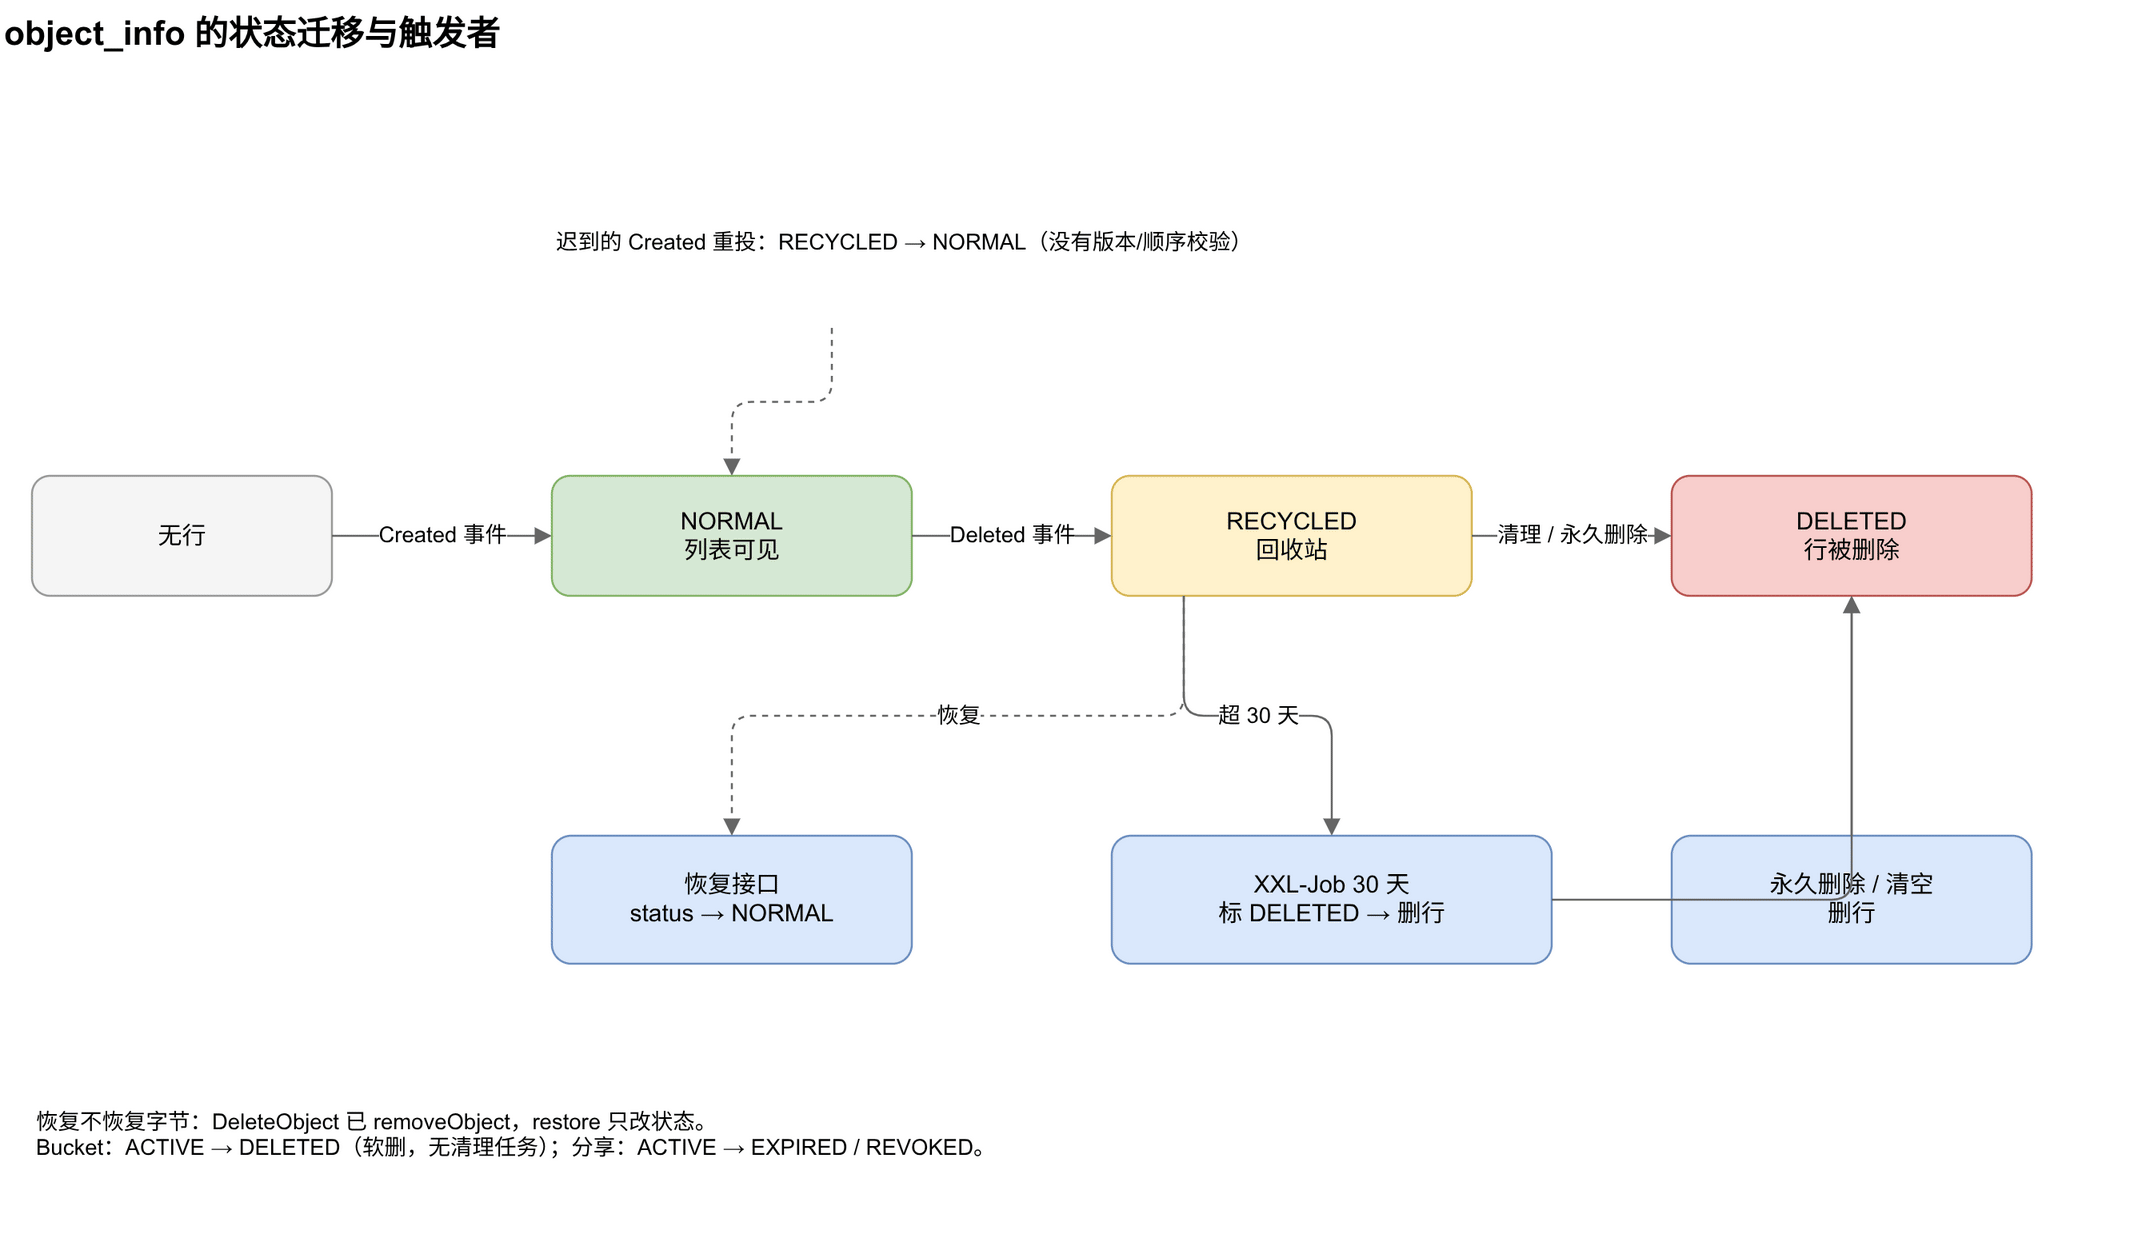
| 起点 | 事件/操作 | 终点 | 谁做的 |
|---|---|---|---|
| 无 | Created 事件 | NORMAL | 消费者插入 |
NORMAL | Deleted 事件 | RECYCLED | 消费者 |
RECYCLED | 恢复接口 | NORMAL | RecycleServiceImpl.restoreObject |
RECYCLED | 永久删除 | 行删除 | permanentDelete / emptyRecycleBin |
RECYCLED | 超过 30 天 | DELETED → 行删除 | cleanExpiredObjects |
| 任意 | 再次 Created 事件 | NORMAL | 消费者 UPSERT |
Bucket 与分享是另外两条独立的状态机:
bucket_info.status:ACTIVE→DELETED,只有软删,没有物理清理任务;share_link.status:ACTIVE→EXPIRED(超时或次数用完)/REVOKED(创建者撤销)。
5. 补偿与定时任务
| 任务 | 调度建议 | 实际动作 |
|---|---|---|
outboxRetryHandler | 每 30 秒 | 取 status in (PENDING, FAILED) 且 retry_count < 5 的前 100 条,按类型选 routing key 重投;成功改 SUCCESS,失败改 FAILED 并加 1 |
outboxDeadCleanupHandler | 每 1 小时 | 取 retry_count >= 5 且创建超过 24 小时的前 100 条,直接删 |
recycleCleanupHandler | 每天 03:00 | 取 RECYCLED 且 updated_at 超过 30 天的 100 条,标 DELETED、调存储删除、删行 |
调度由 XXL-Job 控制台配置,代码只提供 handler 名。三个任务都按 100 条一批,recycleCleanupHandler 会循环到取不满一批为止。
重试任务的 retry_count 在成功时也会加 1。成功消息已经是 SUCCESS,不会再被扫到,所以这个计数只影响失败路径的“最多 5 次”。next_retry_at 写了但没读,30 秒一轮的实际间隔由调度器决定,不是 5 分钟。
6. 没有被收敛的不一致
这几处不是偶发故障,是当前设计的结果。读代码时按“已知行为”对待:
删除不减 used_bytes。 ObjectDeletedConsumer 只改状态。bucket_info.used_bytes 与 sum(size) where status='NORMAL' 会越差越多。实测本地库里 test 桶 used_bytes = 1,050,967,NORMAL 对象合计 1,048,657,差的那部分就是删掉的对象。
恢复不恢复字节。 DeleteObject 先 removeObject 再发事件;消费者把行标成 RECYCLED。恢复接口只把状态改回 NORMAL,存储里已经没有这个对象。列表能看到、下载 404。
复制没有事件。 copyObject 只在目标 Bucket 的后端写了对象,没有调用 objectEventProducer,所以目标对象不会出现在 object_info,也不会出现在列表里。下载靠存储里的实际对象仍能成功,索引与存储因此分叉。
乱序会让对象复活。 事件没有版本号或时间戳校验。Created 的 PENDING 记录在下一轮重试时,如果 Deleted 已经先被消费,这条“迟到”的 Created 会把行重新 UPSERT 成 NORMAL,而文件已经不在了。
Bucket 删除不失效存储类型缓存。 bucket:storage:{bucket} 还能活 1 小时,期间对象链路继续按旧类型工作。
Outbox 重试没有上限之外的告警。 超过 5 次的行会在 24 小时后被静默删除;没有指标、没有告警,也没有人工补投入口。
7. 要更强一致,缺的是哪几块
按代价从低到高:
- 删除事件里带上要减的
size,在ObjectDeletedConsumer里原子减used_bytes。表结构不用改。 - 复制后补发 Created 事件,与上传路径共用同一个 producer。
copyObject已经能拿到目标 ETag。 - 恢复前检查存储对象是否存在,不存在就拒绝恢复或标成缺失,而不是把行改成 NORMAL。
- 给事件加版本或时间戳,消费者拒绝比当前行更旧的事件,解决乱序复活。
- 加一个对账任务:按 Bucket 扫描存储对象与
object_info,补缺行、删孤儿行、重算used_bytes。这是把“事件流是唯一来源”改成“存储是来源、索引可重建”的分界线,需要新的扫描接口。
前三条是局部修改,第四条要把 object_info 的更新口径改成带版本比较,第五条是一套新任务。当前代码一条都没做。