

检索与问答
检索与问答
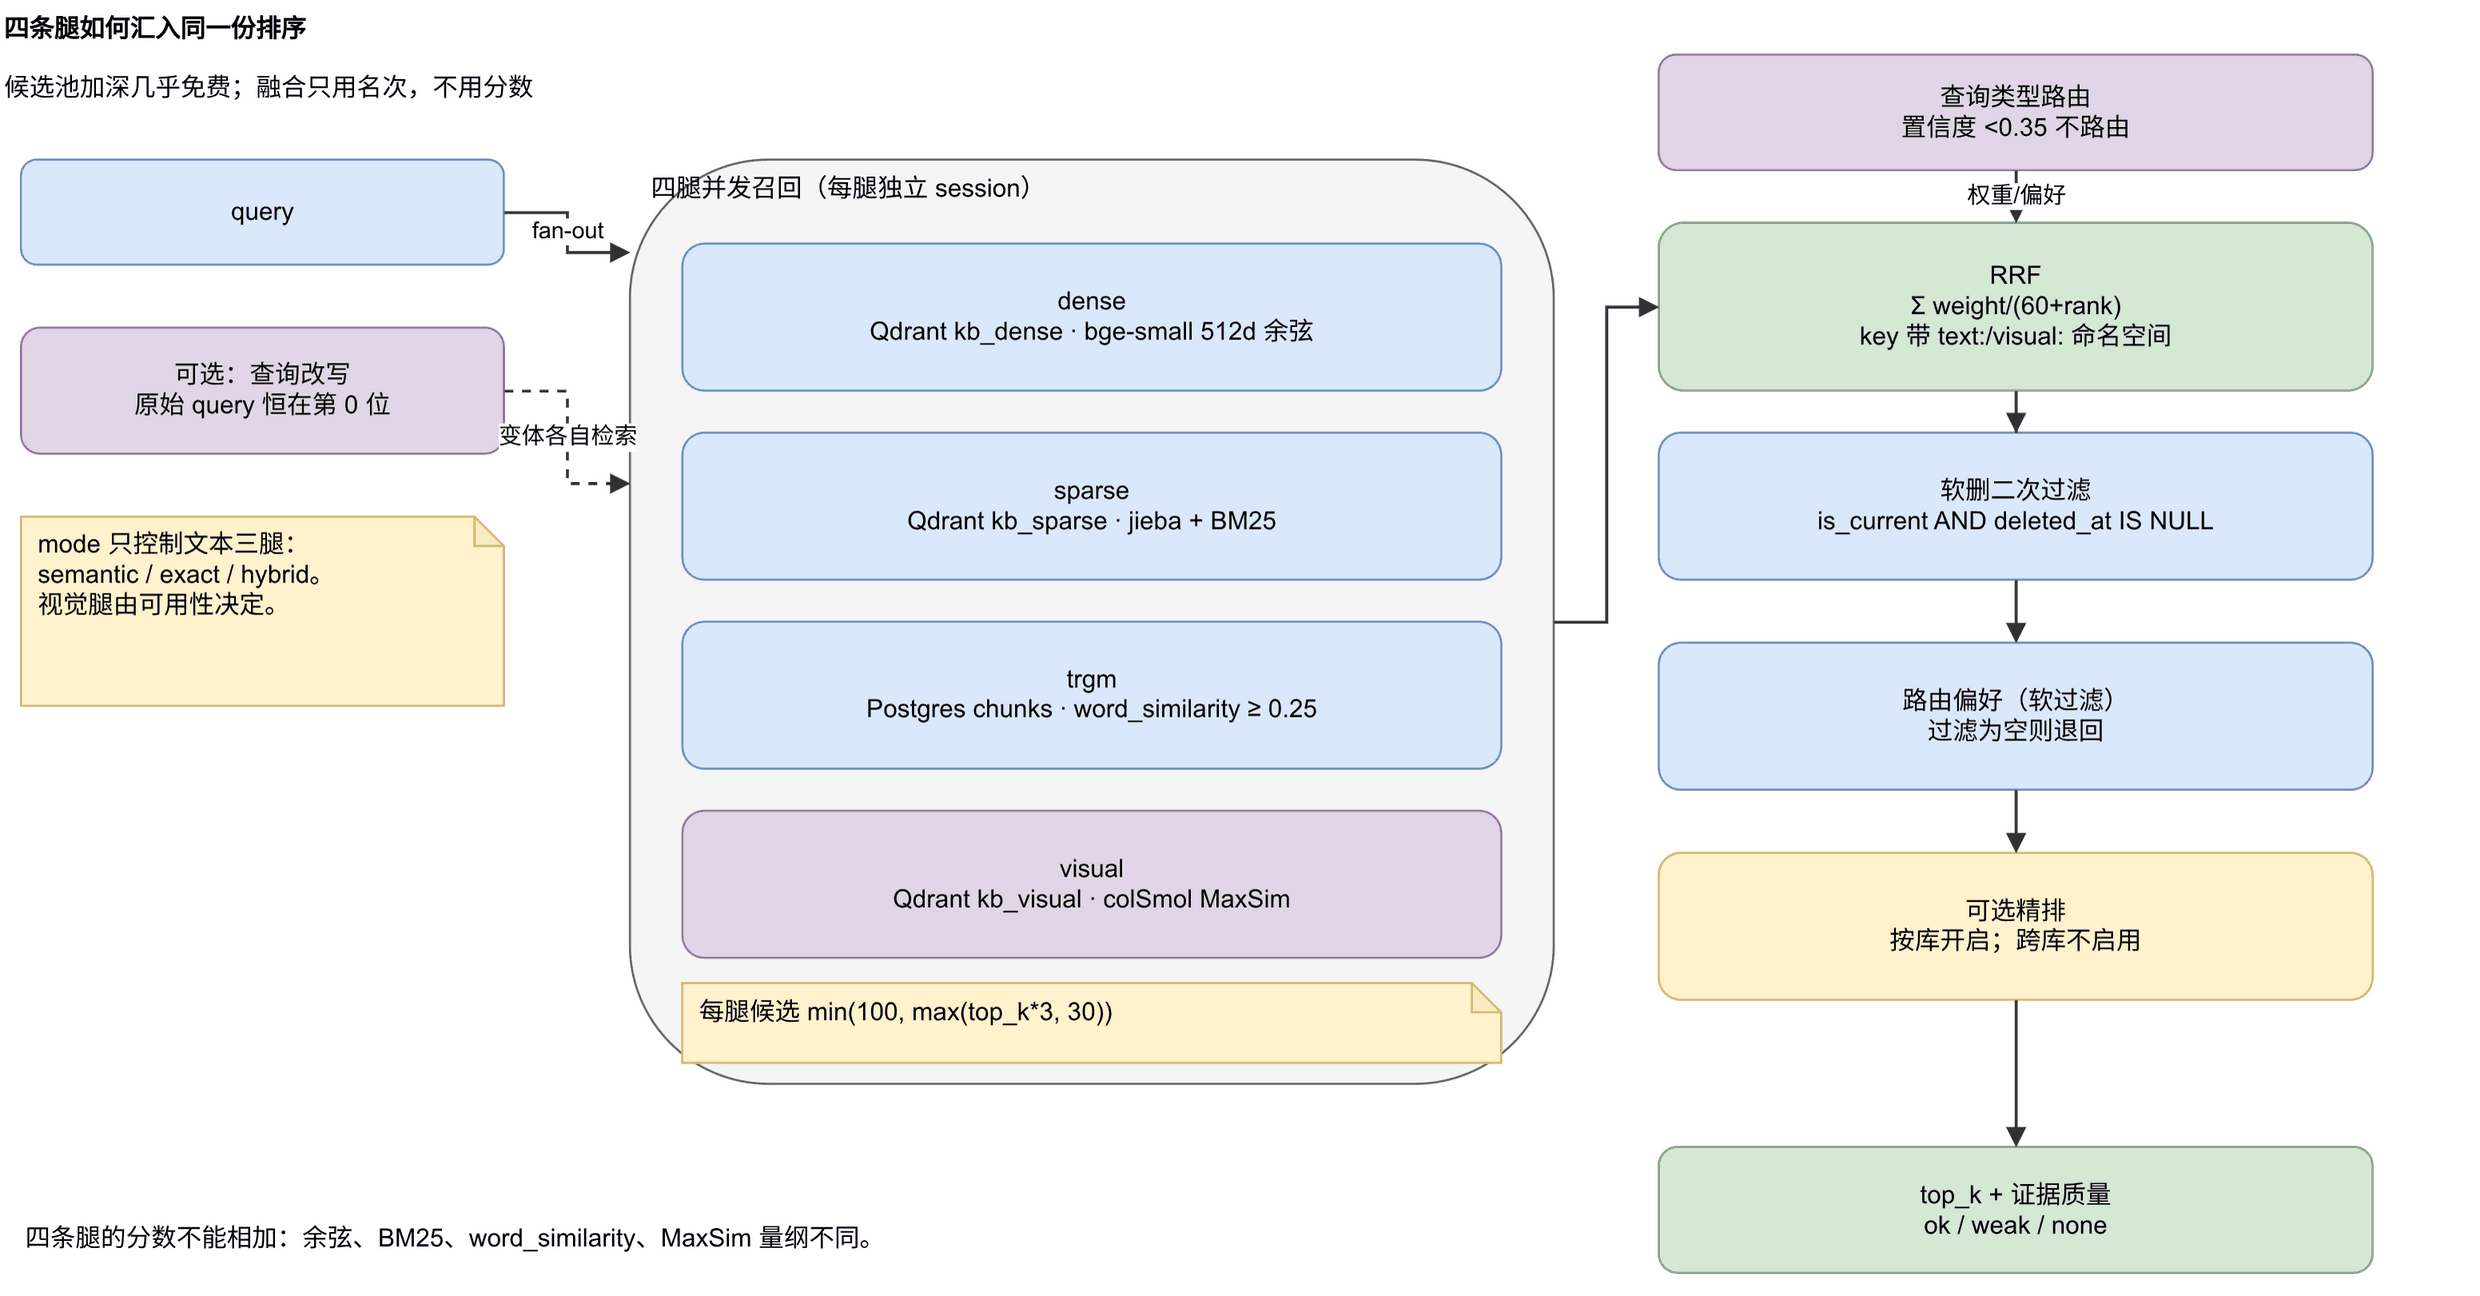
1. mode 与四条腿
| mode | 走的腿 | 能搜什么 |
|---|---|---|
semantic | dense | 意思相近的段落 |
exact | trgm | 子串:手机号、工号、错误码、变量名 |
hybrid(默认) | dense + sparse + trgm | 三路 RRF |
| — | visual | 照片与扫描页,由服务可用性决定,不在 mode 里 |
| 腿 | 实现 | 查询条件 | 强项 |
|---|---|---|---|
| dense | bge-small-zh-v1.5 编码后查 kb_dense | 余弦 | 语义泛化 |
| sparse | jieba + BM25,查 kb_sparse | 稀疏内积 | 关键词、人名、学号 |
| trgm | Postgres word_similarity | >= 0.25 | 非词字符串 |
| visual | colSmol multi-vector MaxSim,查 kb_visual | 页级 | 照片、扫描件 |
visual 不在 MODE_LEGS 里。engine._gather_legs 总是把它并进任务列表,不可用时它自己立刻返回 skipped,这样调试面板能显示"这一腿存在但没跑",而不是让它消失、让人以为库里没有照片。
每腿候选深度:
per_leg = min(100, max(top_k * 3, 30))   # CANDIDATE_MULTIPLIER=3, MAX_CANDIDATES=100
fused = rrf(leg_results, limit=top_k * 2)
加深几乎免费,因为查询编码只做一次;上限 100 是防 top_k=100 × 3 把 payload 传得过大。
2. 三条 DB 腿的并发
三条文本腿都要碰 Postgres:dense 查 index_models 校验模型一致性,sparse 查词表与 corpus_stats,trgm 直接查 chunks。把它们交给同一个 AsyncSession 并发 execute 会抛:
This session is provisioning a new connection; concurrent operations are not permittedsparse / trgm 会被记成 skipped,hybrid 静默降级成 dense 单腿,接口仍然返回 200。单库路径因为 assert_kb_access 预热过会话,碰巧不触发;跨库、MCP、A2A 与直接调 engine.search 的冷会话会踩到。
所以每条 DB 腿从 get_async_sessionmaker() 各拿一个会话:
async with factory() as s:
    return await search_dense(ctx, query, ..., session=s)
视觉腿不碰 DB,不需要会话。四条腿一起 anyio.gather。
代价是连接数:一次 hybrid 最多 4 条(请求会话 + 3 条腿)。连接池要按并发检索数 × 4 估,不够时请求排队,延迟变差但不会算错。
3. RRF 融合
四条腿的分数量纲互不相同,不能加权求和:
| 腿 | 分数形态 | 观测范围 |
|---|---|---|
| dense | 余弦 | 0.2 ~ 0.9 |
| sparse | BM25 | 0 ~ 40+,随语料增长 |
| trgm | word_similarity | 0.25 ~ 0.40 |
| visual | MaxSim | 0 ~ 1 |
RRF 只看排名:
score(d) = Σ_leg weight_leg / (k + rank_leg(d)) # k = 60k=60 是原论文取值。它让 rank 1 与 rank 2 的分差只有约 0.26%,头部的微小优势不会压倒第二条腿的共识。
融合键带命名空间(text:<id> / visual:<id>)。不带的话,「文本 chunk 3」与「扫描页 3」会互相抵消——两个 collection 的点 ID 都从同一套哈希来,但页级点的 chunk_index 是负数,命名空间是第二道保险。
排序键是 (-score, key)。只按分数排时,并列项的先后会随字典序抖动,前端的 [1] [2] 刷新一次就对调。
默认权重全 1.0。实测等权 RRF 在每个类别上都没有赢过该类的最佳单腿,所以调整不在融合层做,而在路由层按 query 类型换权重。
4. 查询路由与软偏好
routing.classify 用正则识别六类意图,低于 MIN_CONFIDENCE = 0.35 就退回 general(等权、不过滤)。
| 意图 | 命中词示例 | 权重 | 偏好 |
|---|---|---|---|
photo | 照片、合影、自拍、拍的 | visual 3.0 | source_kind=photo |
scan | 扫描件、影印件、拍下来的那份 | visual 2.0 + sparse 1.2 | kind in (page, table) |
table | 哪一栏、怎么填、表头 | sparse 1.3 + trgm 1.2 | kind=table |
chat | 聊天、提过、说过什么 | sparse 1.6 | kind=chat 或 source_kind=chat |
date | 哪天、什么时候、2023年5月 | sparse 2.5 | 无 |
photo 的 3.0 是实测出来的,不是拍的:在 60 个 photo 点 + 60 个 text 点、top_k=10 的配置下,权重 2.0 时融合池里 10/20 是照片、top10 里 5/10;3.0 时 20/20 与 10/10;4.0 与 6.0 不再增加。3.0 是让照片点能把 top_k*2 的池装满的最小值。
prefer 是软过滤,不是硬排除:
sub = [h for h in kept if _hit_kind(h) in route_obj.prefer_kinds]
if sub:
    kept = sub
else:
    note += ";库里没有对应类型,不做过滤"
过滤后为空就退回全部,说明写进 route_note。硬排除加空结果,用户看到的是 0 条。
多意图同时命中时取更具体的那一个,不求和:「去年五月去旅游拍的照片」命中 photo 与 date,取 photo。
date 的识别还包括日期字面量本身(2023年5月1日),此时置信度 0.6。纯日期串落到 general 的话,dense 召不回它。
5. 二次过滤、精排与证据质量
融合之后先挡软删:
alive = {id for id in ... where Document.is_current and Document.deleted_at is None}一次 IN (...) 查询,代价与 top_k 成正比,与语料规模无关。顺序不能改:软删过滤在路由偏好之前,否则被路由滤掉的命中会先被算进 filtered_out,那个计数就失去含义。
精排按库启用。knowledge_bases.rerank_model 为 NULL 表示不启用,不回退到全局默认;跨库检索一律不启用,否则排序取决于"哪些库碰巧配了模型"。
| 项 | 值 |
|---|---|
| 默认模型 | BAAI/bge-reranker-v2-m3 |
| 单对耗时 | 114ms(base 是 53ms,但成对判别 2/4 对 4/4) |
| 候选上限 | 前 limit 个,其余保持原顺序接在后面 |
| 截断 | max_length=512 token |
| 失败 | 保持原顺序,skipped 带原因 |
精排只重排候选,不能把真值召回。真值不在候选里,它救不回来。
证据质量是三档纯函数,只看已有的 legs 字段:
| 档位 | 条件 | 用途 |
|---|---|---|
ok | 头部 5 条里最强证据有 ≥2 条腿认可 | 正常 |
weak | 有命中,但只来自一条腿 | 给 LLM 生成器的"证据不足"信号 |
none | 没有任何命中 | 外部生成器直接拒答,不调模型 |
none 遇到抽取式生成器时不额外处理:抽取式自己会在摘不出句子时拒答,保持原有文案。
6. 证据组装与 SSE
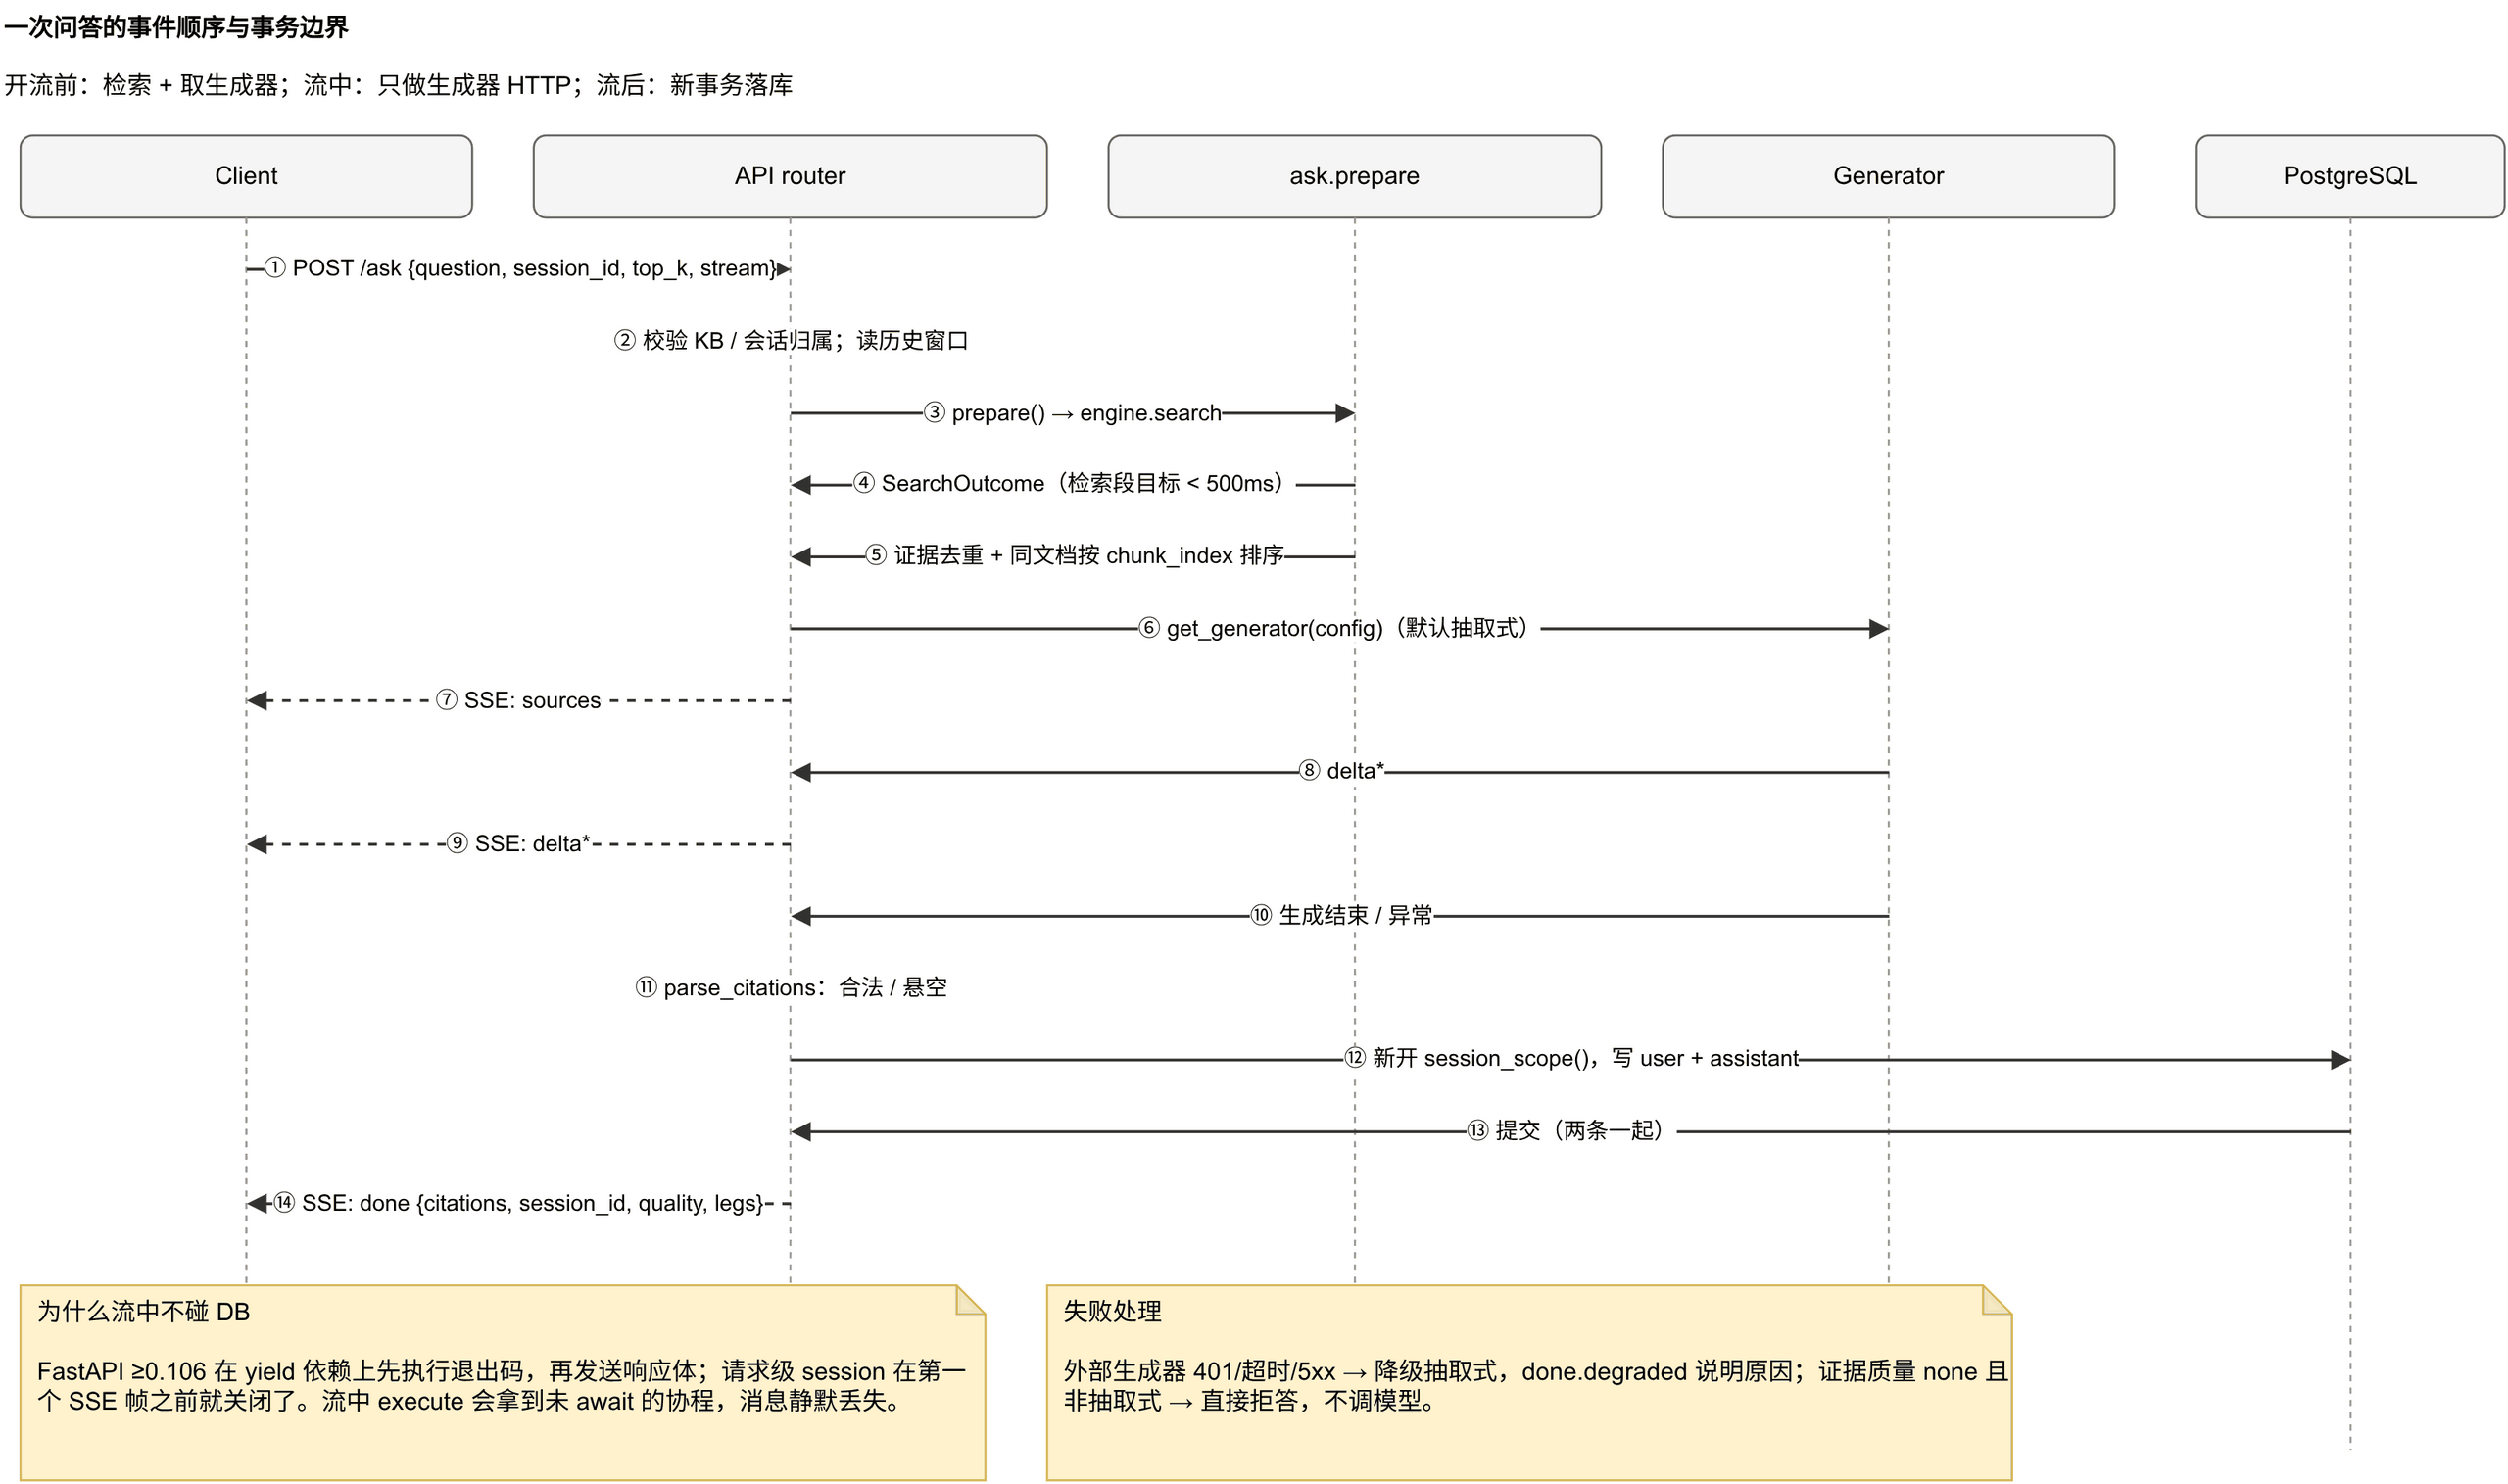
ask.prepare 在开流之前做完所有计算:
load_history读最近ask_history_turns=4条消息,按ask_history_chars=4000裁剪,按整轮丢弃最旧的。- 指代式追问(长度 ≤
ask_anaphora_max_chars=24)把上一轮问句并进检索 query。这一层与生成器无关,抽取式也受益。 search取top_k=8(HTTP 上限 50)。to_evidences去重、重排idx、同文档的相邻片段按chunk_index升序。
第 4 步的两个细节:
- 去重按
(doc_id, chunk_index)。重复证据会让[1]和[2]指向同一段文字,角标失去意义。 - 文档之间的相对顺序取首次出现的位置,只调整文档内部的块顺序。模型读到的同一篇文档是连贯的一段,而不是跳着读。
证据正文默认 400 字符;payload.parent_text 存在时改用父块,上限 1200 字符。
SSE 帧序固定:
event: sources   ← 检索完成就发,前端此时能画引用卡片
event: delta     ← 逐段,stream=false 时只有一个
event: done      ← citations / dangling_citations / degraded / session_id / legs
sources 先于任何 delta 是契约要求,前端据此区分"还在检索"与"在生成"。
三个实现约束:
- SSE 生成器里只做 LLM 的 HTTP 往返,不碰 DB。FastAPI 在
yield依赖上把退出码放在响应体开始流式之前执行,请求级会话在开流时已经提交并关闭。在生成器里session.execute()会得到一个永远不会被 await 的 coroutine,消息静默丢掉。 - 落库在流结束后新开
session_scope(),user 与 assistant 两条消息一起写。中途失败就都不写,不留"有提问没回答"的孤儿会话。 stream=false仍然返回 SSE,只是一个delta。少一条响应格式,MCP、A2A、浏览器共用一条代码路径。
done 里的字段各有用途:
| 字段 | 含义 |
|---|---|
citations | 答案里出现且在 1..N 范围内的角标 |
dangling_citations | 引用了不存在的来源,正常应为空 |
degraded | 外部生成器失败后降级为抽取式的原因,未降级为 null |
history_turns | 这一轮带进生成的上下文轮数 |
quality | {level, reason, max_legs} |
legs | 每腿的 n / ms / skipped |
外部生成器失败不会变成 500。openai_compat 的 401、超时、5xx 会退回抽取式,把同一批证据再讲一遍,并在 done.degraded 写明原因。已经流出部分 LLM 文本时不再追加,避免两份答案拼在一起。
7. 降级清单
skipped 是字符串表示没跑,null 表示跑了但零命中。把两者混在一起,会把"视觉服务没起"读成"库里没有照片"。
| 腿 / 环节 | 跳过条件 | 检索结果 |
|---|---|---|
| dense | index_models 记录的模型或维度与当前配置不一致 | 200,其余腿照常 |
| sparse | 查询词分词后全不在词表 | 200,这一腿 0 候选 |
| trgm | query 短于 3 字;或语句超过 TRGM_STATEMENT_TIMEOUT_MS=800 | 200,降级说明带调参提示 |
| visual | 未配置 VISUAL_SERVICE_URL、服务不可达、模型未加载完、编码超 2s、并发排队超时 | 200,这一腿 skipped |
| rerank | 该库未配 rerank_model、模型加载失败、推理失败 | 原顺序,skipped 带原因 |
| 生成 | 外部 LLM 不可用 | 抽取式答案,done.degraded 说明 |
mode 只控制文本三腿,视觉腿由服务可用性决定。这条分工让"只跑文本检索"成为显式配置(VISUAL_SERVICE_URL= 留空),而不是靠"服务没起"这种偶然状态。
8. 相关文件
| 文件 | 说明 |
|---|---|
services/retrieval/engine.py | 检索编排、每腿独立会话、软删过滤 |
services/retrieval/fusion.py | RRF 与多查询二次融合 |
services/retrieval/dense.py | 向量腿与模型一致性校验 |
services/retrieval/sparse.py | BM25 查询向量构造 |
services/retrieval/bm25.py | 分词、日期归一化 token、权重公式 |
services/retrieval/trgm.py | 子串腿、语句超时、word_similarity |
services/retrieval/visual.py | 视觉腿与不可用原因 |
services/retrieval/routing.py | 六类意图、权重、软偏好 |
services/retrieval/rerank.py | 按库精排、失败保持原序 |
services/retrieval/quality.py | 证据质量三档 |
services/retrieval/rewrite.py | 规则层与 LLM 层改写 |
services/retrieval/ask.py | 证据组装、SSE 帧、会话落库 |
services/api/routers/search.py | 检索端点、调试块 |
services/api/routers/ask.py | 单库/多库问答、只检索不生成 |