

架构与进程
架构与进程
这个服务把"重活"和"等活"分开了。解析、编码、生成缩略图都要吃 CPU,有的单页就要 15 秒;而用户提问、翻文档、看进度等的是 IO。把两者塞进一个进程,最直接的后果是有人在等文档处理时,全站的问答都会变慢。所以运行时是三个进程,不是一个。
三个进程与端口
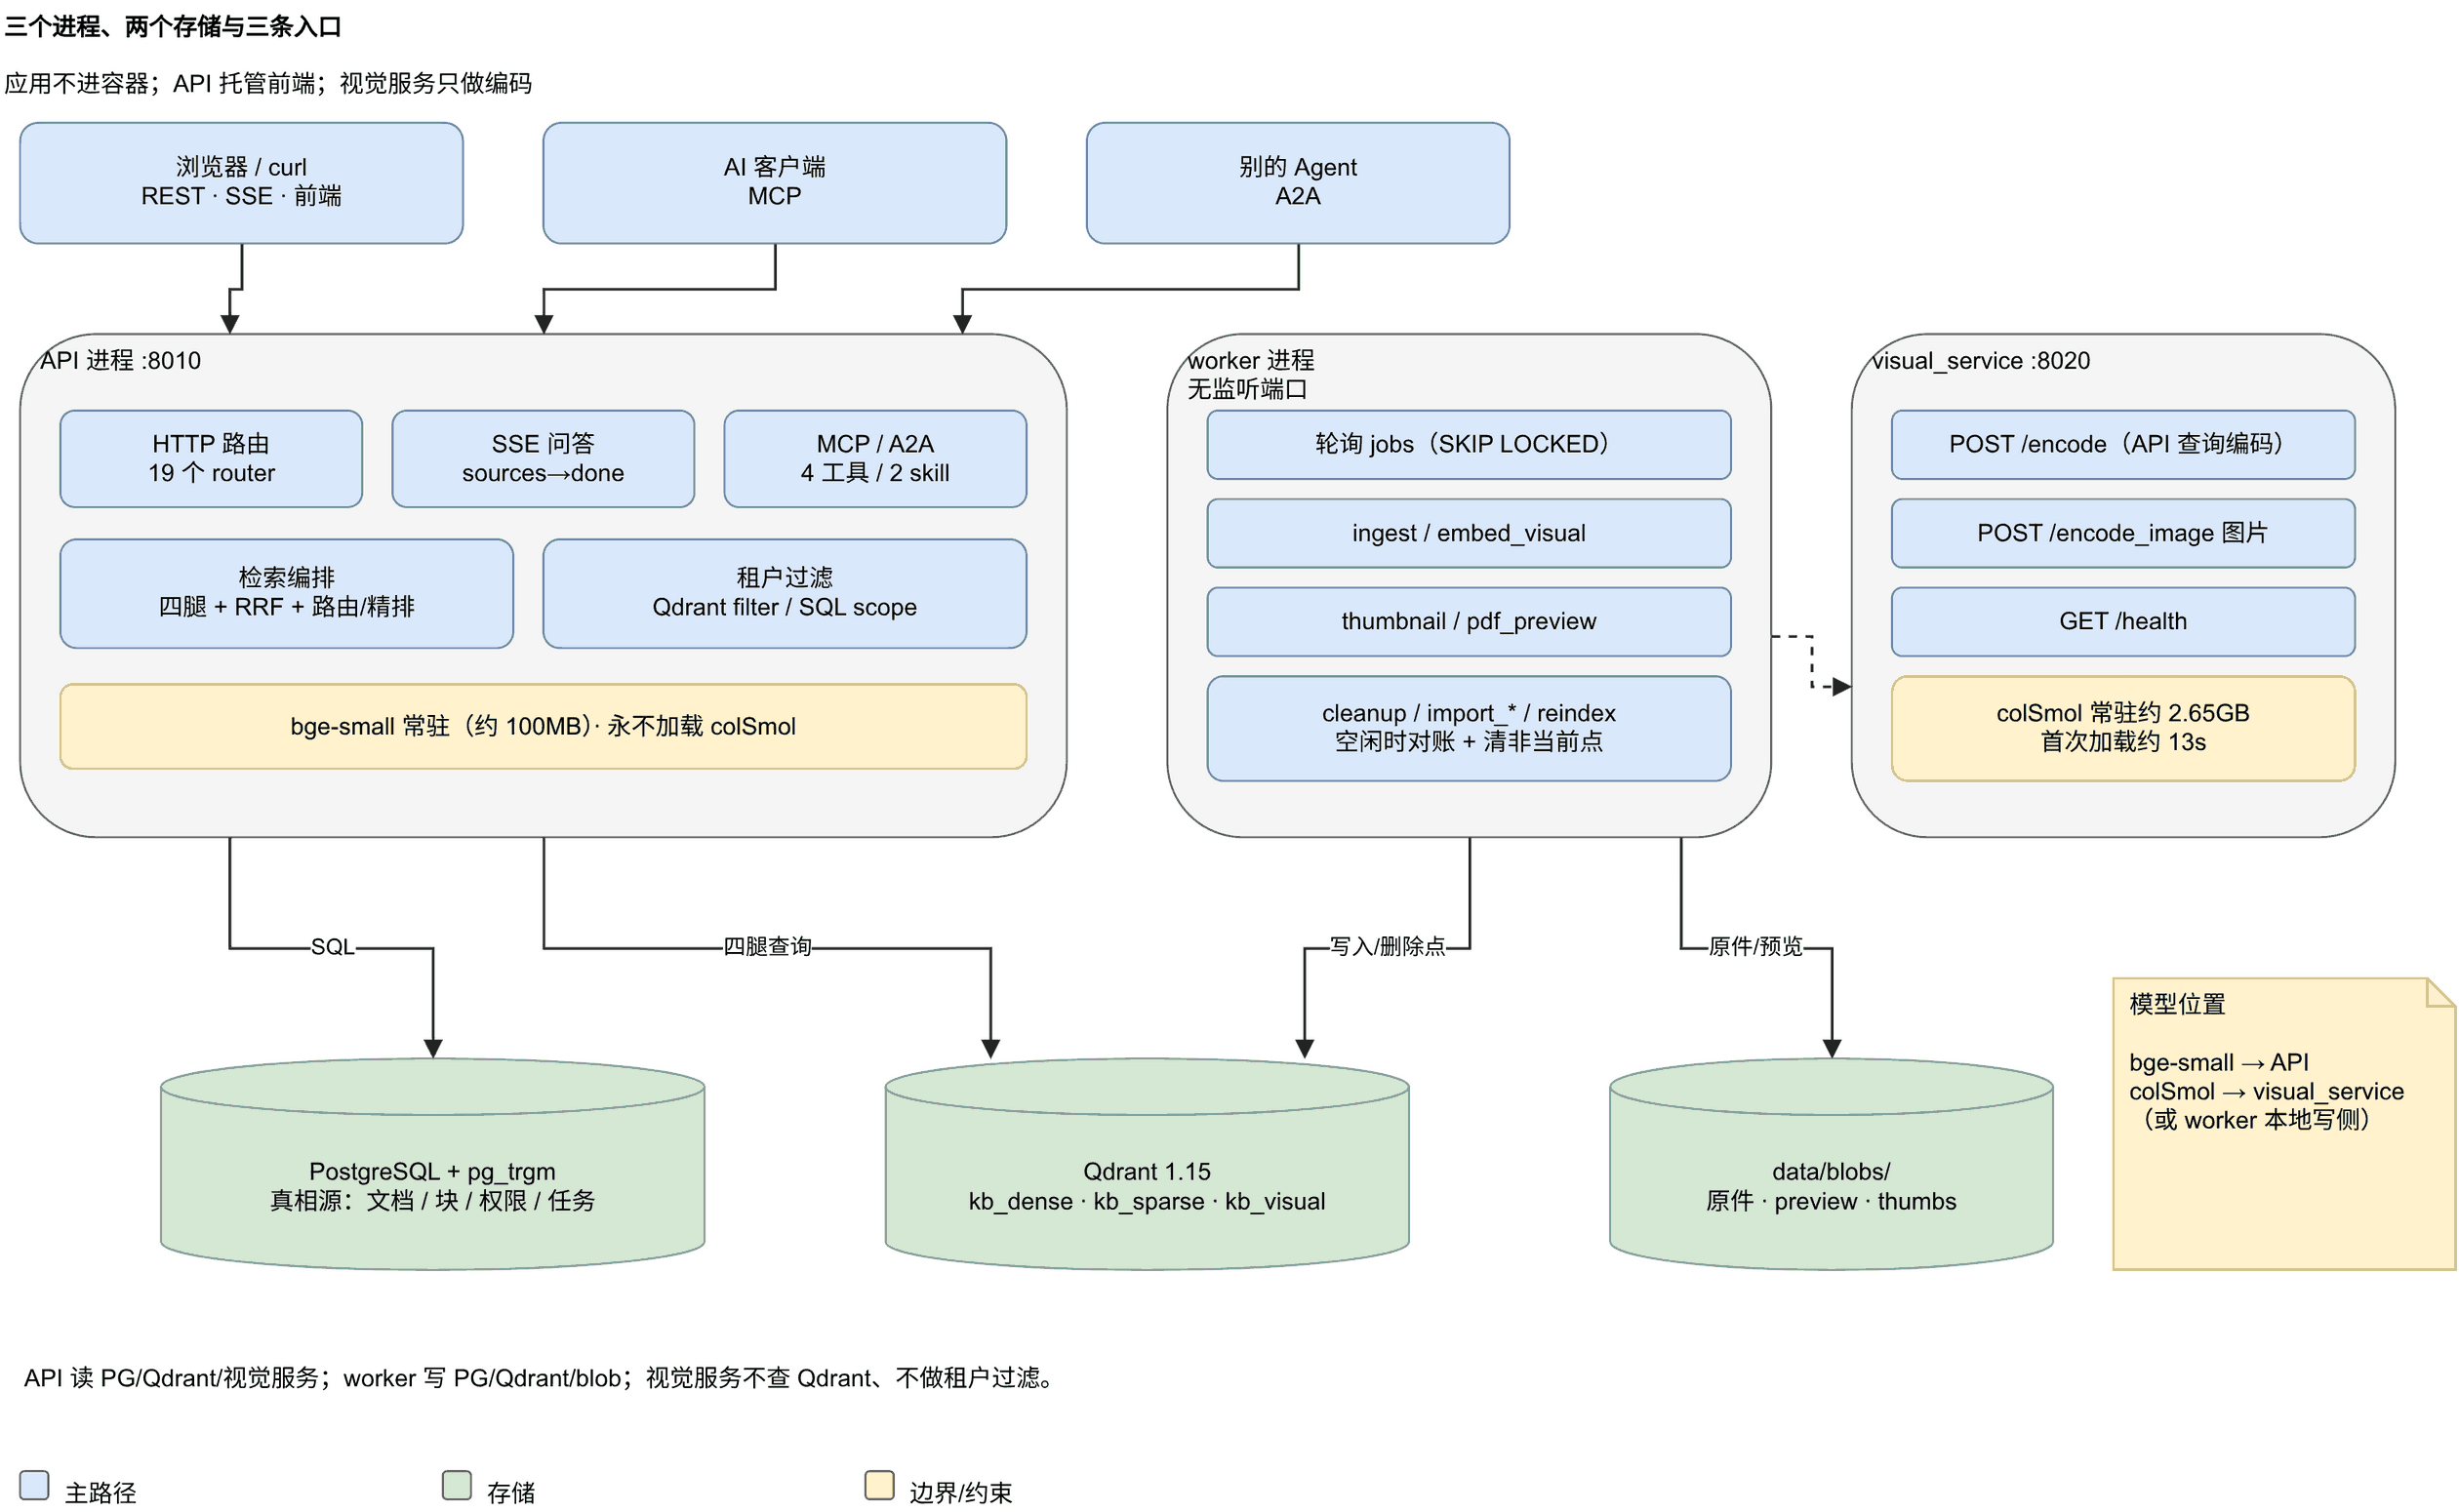
| 进程 | 监听 | 常驻成本 | 什么时候用 |
|---|---|---|---|
| API | 127.0.0.1:8010 | bge-small 约 100MB | 每个请求;启动时预热文本模型 |
| worker | 无 | 文本模型常驻;首个视觉任务后加载 colSmol(约 2.65GB);写侧走远端时只占几百 MB | 轮询任务;VDR_ENABLED=true 且未走远端时本地编码 |
| visual_service | 127.0.0.1:8020 | colSmol 约 2.65GB,首次加载约 13 秒 | 视觉腿可用时,API 每次检索向它要查询向量 |
Postgres 在 127.0.0.1:5432,Qdrant 在 127.0.0.1:6333/6334,都由 deploy/docker-compose.yml 起,应用本身不进容器。前端构建产物由 API 托管,生产只暴露 8010 一个端口。
视觉服务的边界是刻意画窄的:它只做编码。Qdrant 查询、build_qdrant_filter、MaxSim 都在 API 侧完成。把过滤搬进视觉服务,等于把"谁能看哪些库"这条逻辑复制成两份;两份迟早会漂,而漂移的方向是别人看到不属于自己的照片。这条约束比"少一次 HTTP 往返"重要。
一次请求会碰到谁
上传只碰 API 和 Postgres 的同步部分:校验、落 blob、建文档行、入队。真正的解析与索引在 worker 里,API 返回 202 就让前端去轮询。这样即使一次上传 20 个文件、某个 PDF 有几百页,HTTP 请求也不会挂在那里。
检索从 API 开始,同时打向 Qdrant(dense/sparse)、Postgres(trgm)、视觉服务(编码)和本地 Qdrant(visual)。四条腿各自拿一个数据库会话,避免共用 AsyncSession 时并发 execute 报错;代价是一次 hybrid 检索最多占四条连接,连接池要按"并发检索数 × 4"估。
问答在 API 里完成检索和证据组装,SSE 只负责把生成器的增量吐出去。流式期间不碰数据库:请求级会话在第一个 SSE 帧之前就已经关闭,落库在流结束后新开事务。这不是风格问题,违反它会让消息在没有任何报错的情况下丢掉。
模块依赖
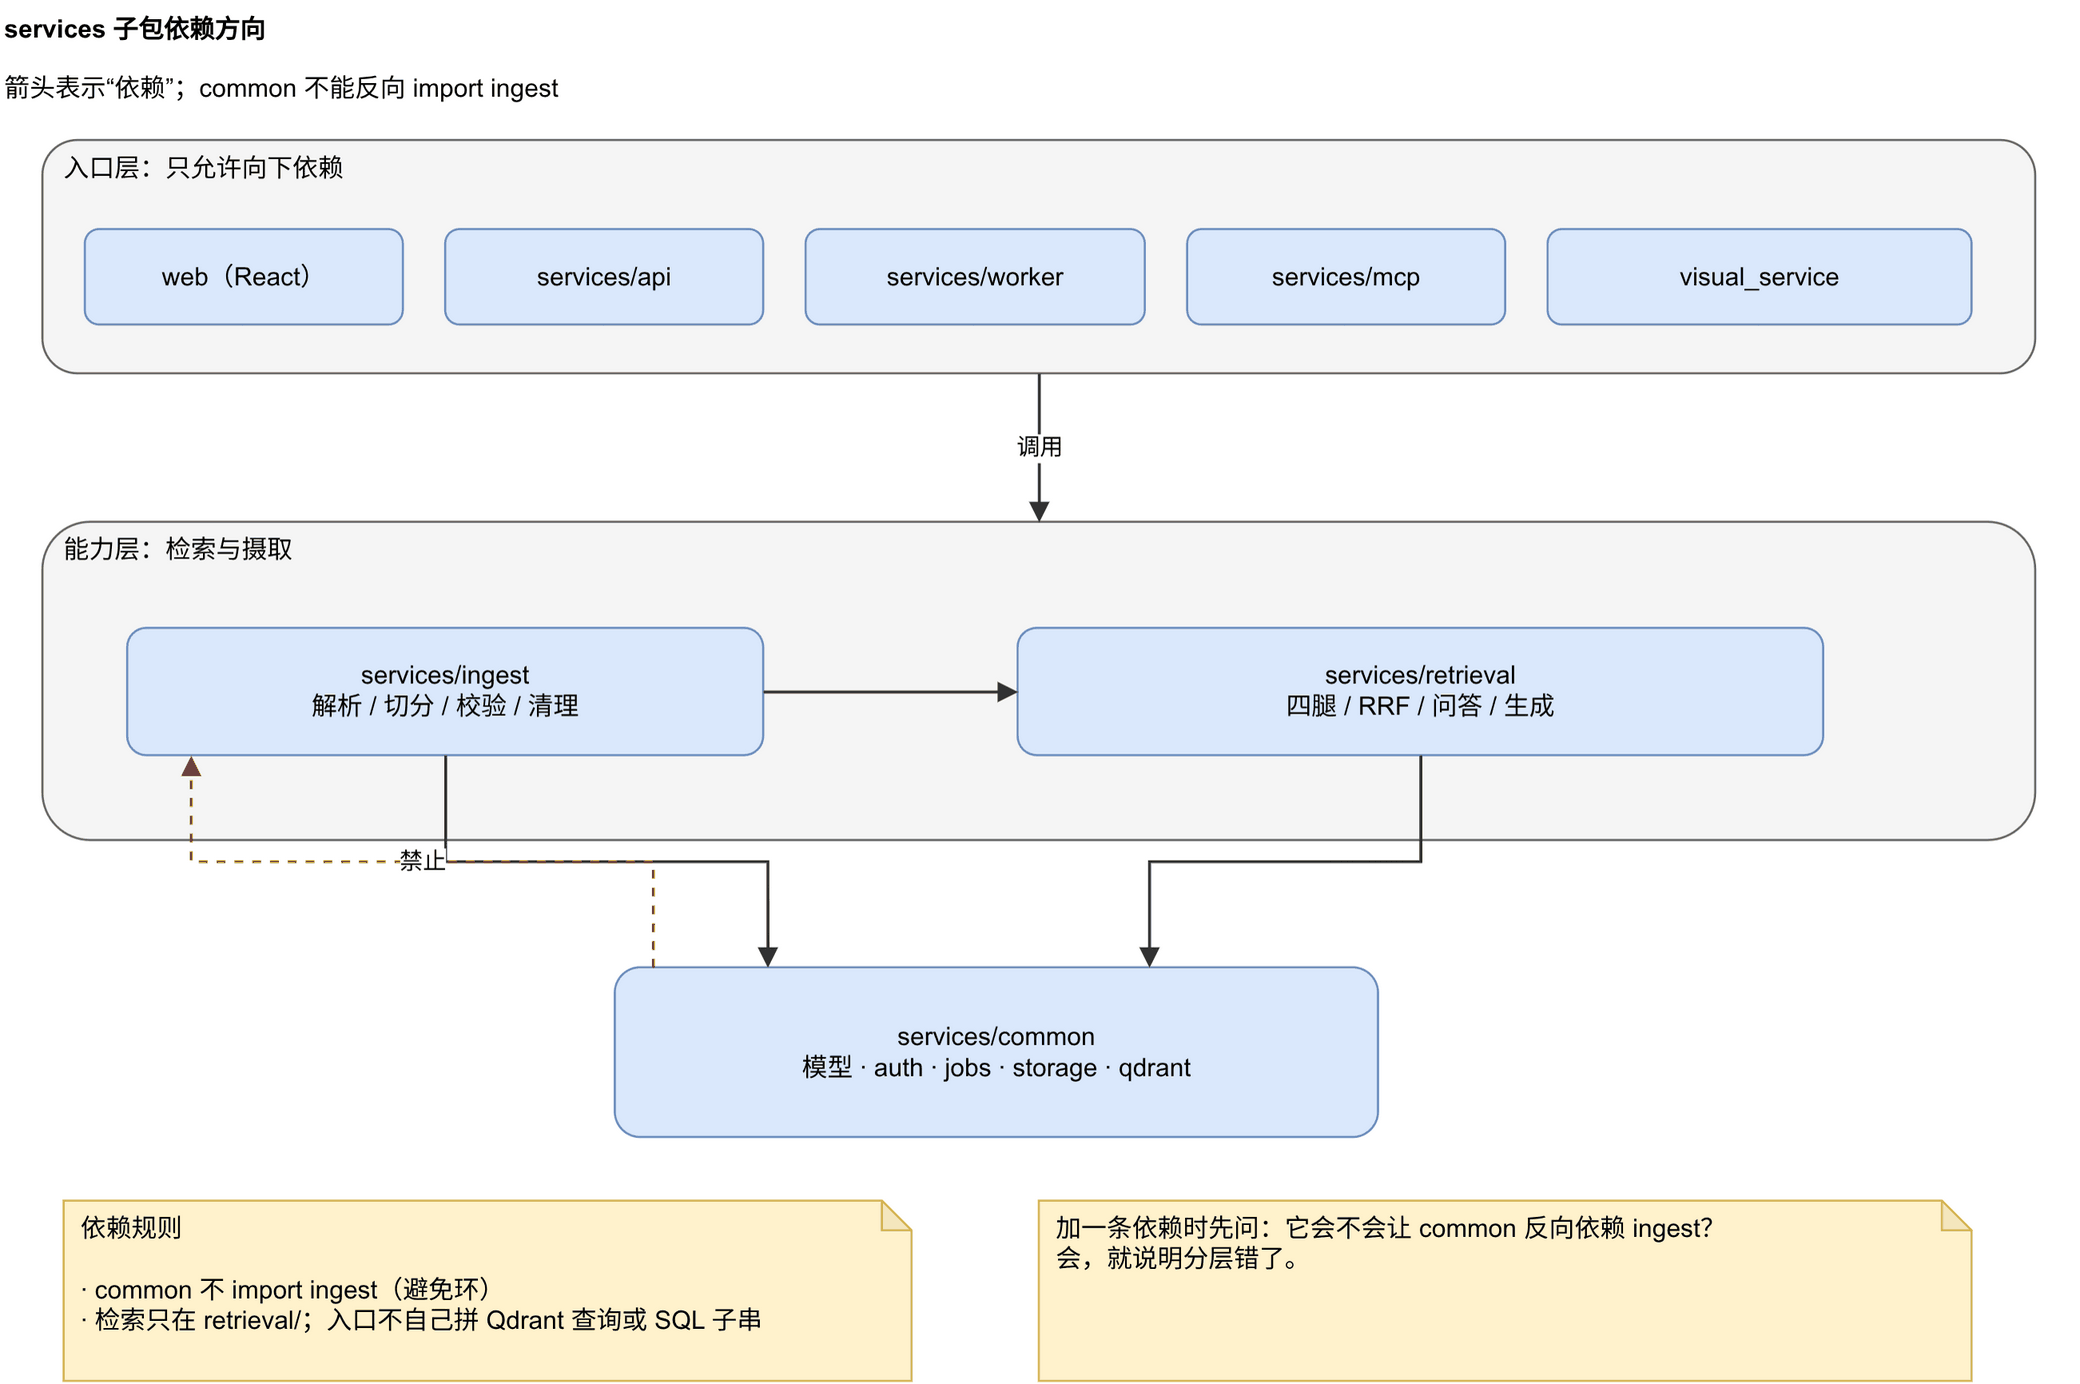
依赖方向是单向的:
api、worker、mcp都依赖retrieval与common;ingest依赖common,common不反向 importingest(否则形成环);visual_service只依赖common的配置与retrieval.pool的编码函数,不依赖api;retrieval是三方共用的唯一检索实现。API、MCP、A2A 只能调engine.search/ask.prepare,不许自己拼 Qdrant 查询或 SQL 子串查询。
这条"唯一实现"不是洁癖。检索有四条腿、两套存储、三种过滤入口,任何一方另写一份,半年后就会出现"网页搜得到、MCP 搜不到"的差异,而这类差异极难排查,因为两边都不报错。
数据平面
Postgres 是真相源:文档、块、权限、任务、审计、词表统计都在这里。Qdrant 是派生索引:三个 collection 的点都能从 Postgres 的 chunk 行和原始文件重建。原始文件按 sha256 存在 data/blobs/,同一个文件被多个版本引用时只存一份。
派生关系带来两条运行时规则:
- 写 Postgres 成功后再写 Qdrant。Qdrant 失败时任务重试,Postgres 数据完好;反过来的话,索引里会有查不到出处的点。
- 删 Postgres 后异步清 Qdrant。检索侧再做一次
is_current AND deleted_at IS NULL过滤,所以"PG 已删、索引还在"的短暂窗口不会把内容递给用户,但会占召回名额。
Qdrant 的点 ID 是 blake2b(kb_id, doc_id, chunk_index) 的稳定哈希。它让"删索引再重建"安全,也让没有 Qdrant 点的 trgm 腿能算出同一个 ID,从而和向量腿在 RRF 里对齐。
降级是一等公民
这个系统里"某条腿没跑"和"某条腿跑了但没命中"必须能分开。视觉服务没起、模型没就绪、trgm 超时、查询词全不在词表、精排模型加载失败——这些都不是 500,而是该腿返回 skipped 并带一句能照着修的原因。检索仍然 200,其它腿照常给结果。
同理,外部生成器超时不会让问答失败:退回抽取式,把原因写进 done.degraded。证据质量为 none 且用的是外部生成器时,直接拒答,不把空证据送给模型编。
部署形态
单机自部署是默认假设:没有 k8s、没有消息队列、没有 APM。任务队列就是 Postgres 的一张表,靠 FOR UPDATE SKIP LOCKED 支持多 worker;巡检是一条能随手跑、退出码有意义的命令;备份只备 Postgres 与 blob,Qdrant 靠重建。这些取舍在任务与运维里展开。
需要多 worker 时,先打开 VISUAL_WRITE_VIA_SERVICE=true,让写侧编码也走 8020,否则每个 worker 都会各自加载一份 colSmol。代价是摄取开始依赖视觉服务:它挂了,照片和扫描件的摄取会失败并重试。这是明说的取舍,不是静默降级。