

架构总览
架构总览
KnowledgeHub 是单机自部署的多租户知识库服务:办公文档、聊天记录与照片进同一个库,切块并建立四路索引(dense / sparse / trgm / visual,行文中统称四条腿),检索与问答的每条结论都能带引用点回原文。三条不能让步的需求决定了架构的形状:
| 需求 | 落到哪个实现 |
|---|---|
| 每条结论都能点回原文 | L3 坐标:chunks.locations 存归一化 bbox,前端乘回页图像素画框 |
| 默认不把原文送出本机 | 生成层默认抽取式,答案句子全部摘自原文;接外部 LLM 必须显式配置 |
| 单机可运维 | Postgres 任务表、一条巡检命令、备份只备事实、索引靠重建 |
明确不做的事:OCR(扫描件只走视觉召回)、对象存储、Redis 或消息队列、k8s、细粒度 RBAC、多实例横向扩展。
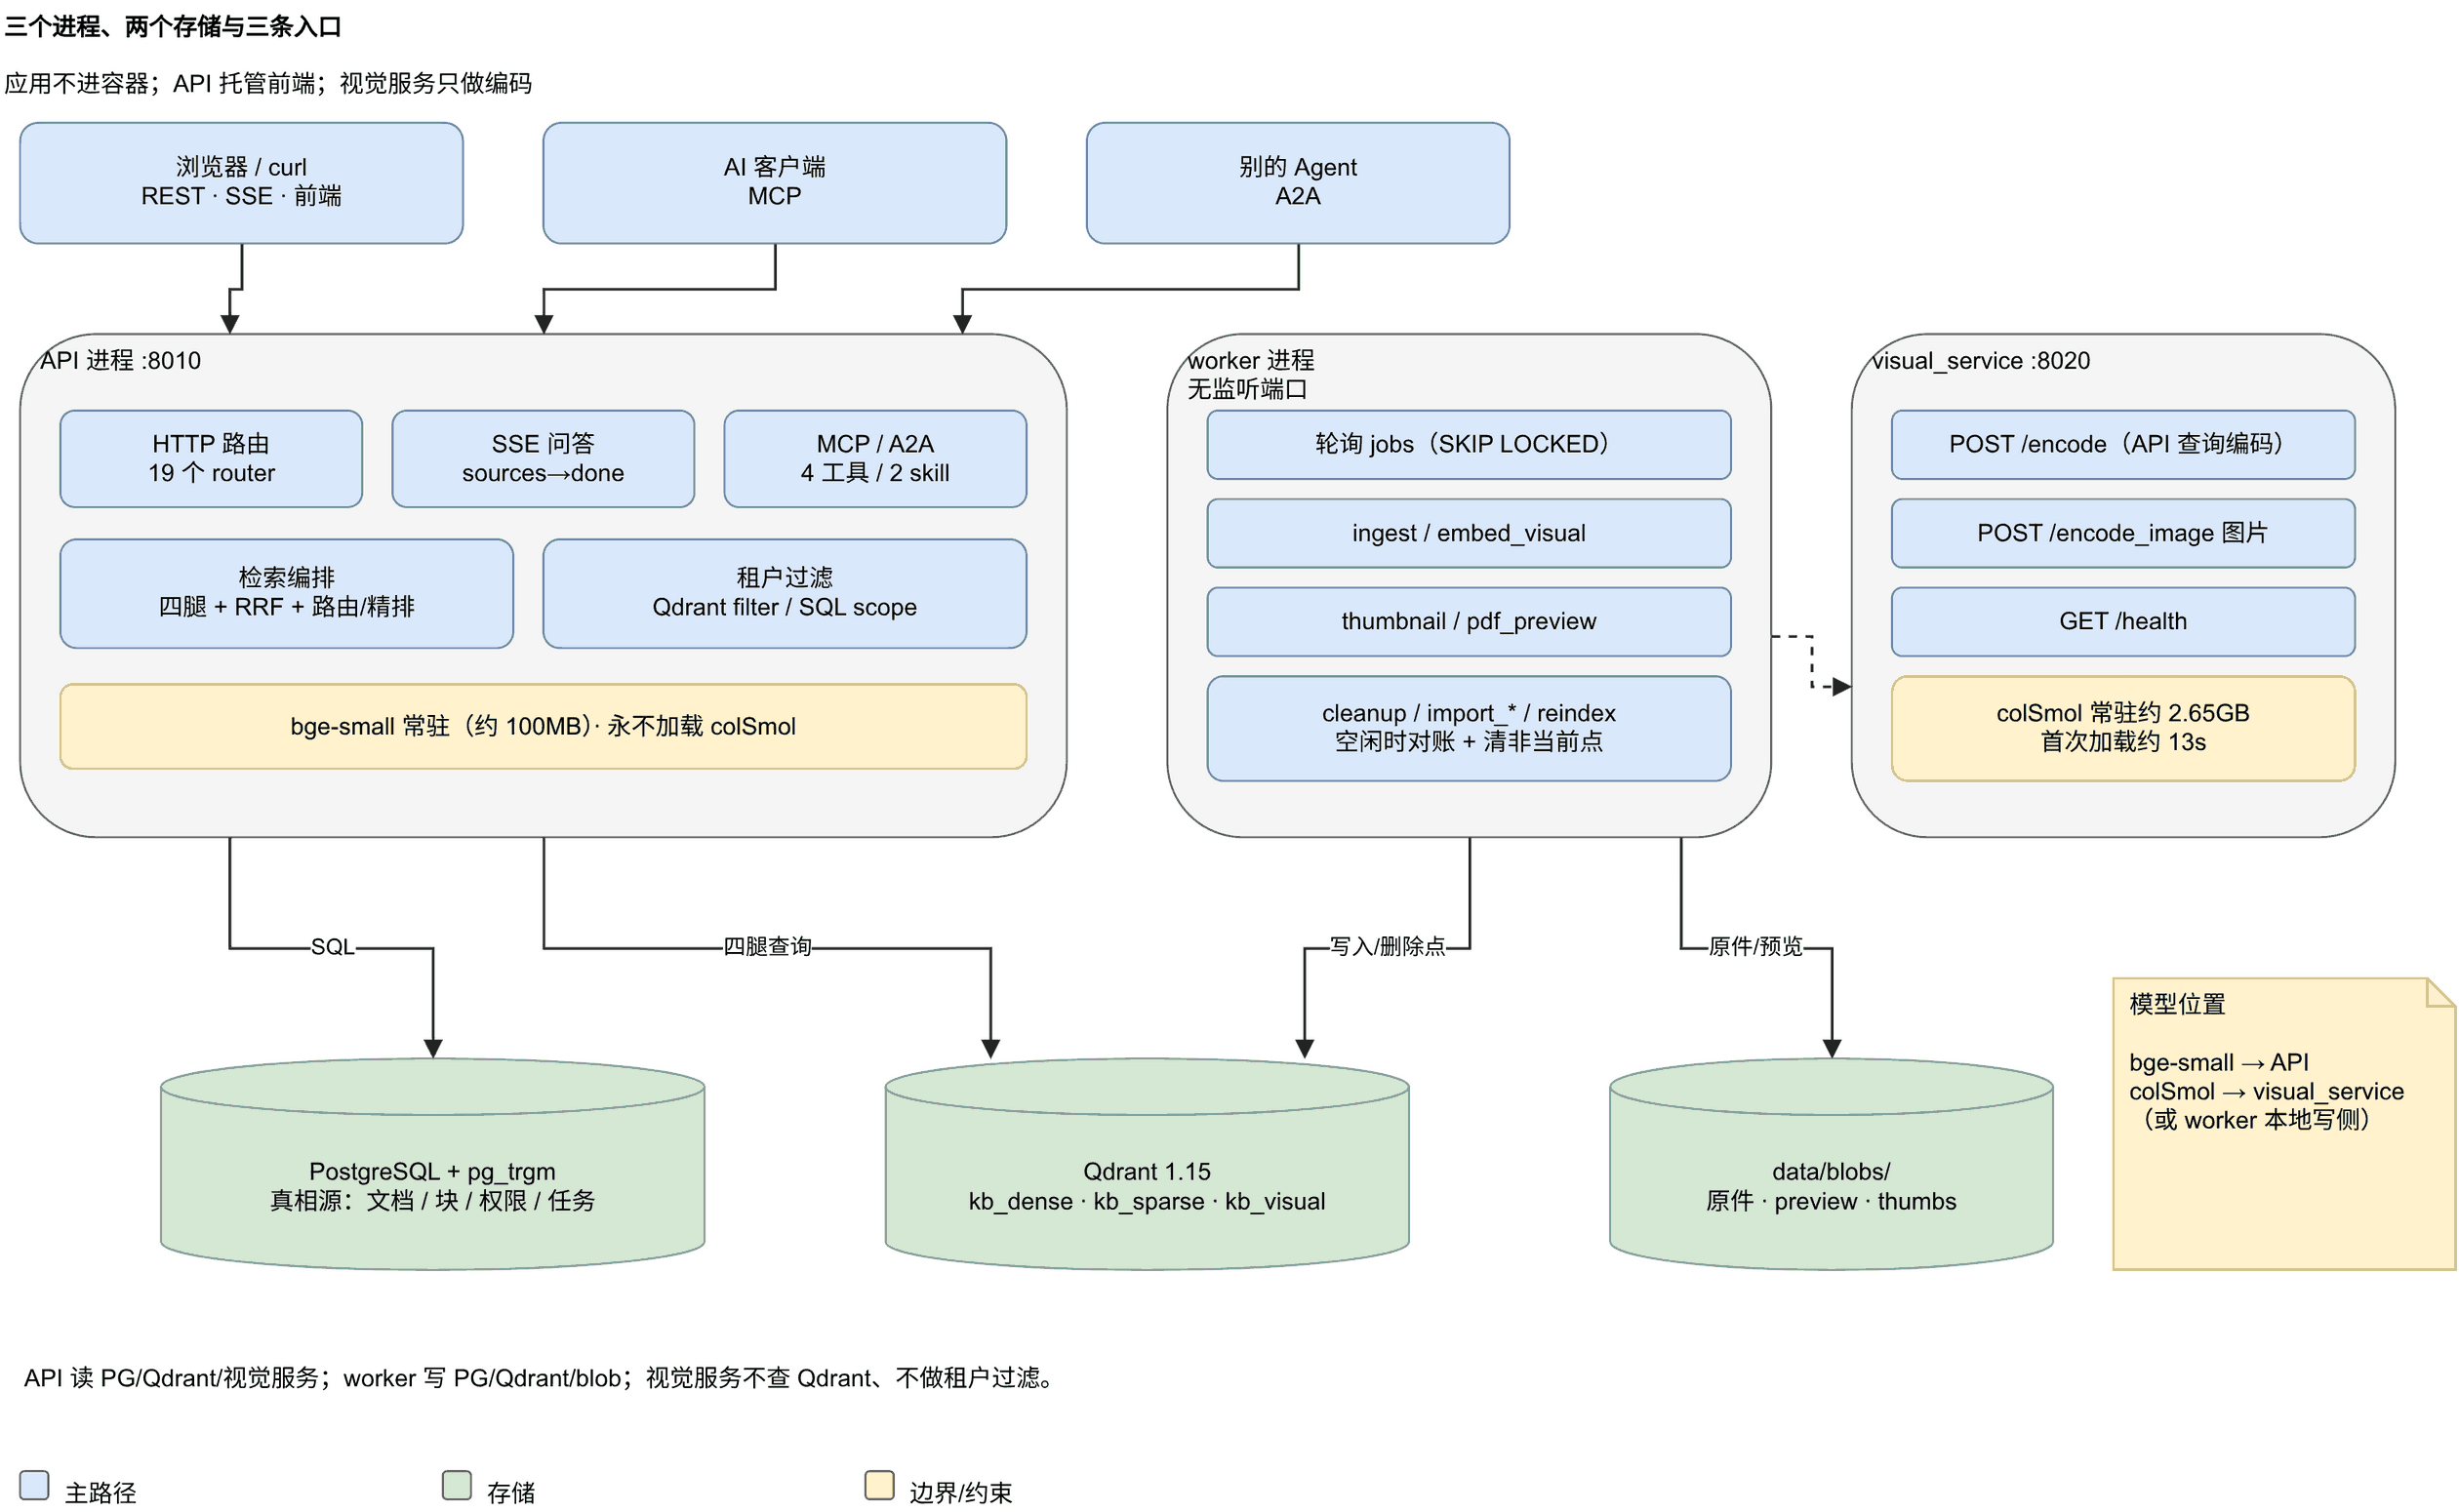
1. 三个进程
| 进程 | 启动 | 端口 | 常驻内容 | 职责 |
|---|---|---|---|---|
| API | uv run uvicorn services.api.main:app | 8010(PKH_API_PORT 可覆盖) | bge-small | REST / SSE、MCP、A2A、托管 web/dist |
| worker | uv run python -u -m services.worker.main | 无端口 | colSmol(可关) | 轮询 jobs 表,执行摄取、清理、定期对账 |
| visual_service | uv run uvicorn services.visual_service.main:app | 8020(PKH_VISUAL_PORT) | colSmol | 只把文本或图片编码成 multi-vectors |
deploy/dev.sh start 拉起 API 与 worker 并委托 visual.sh 起视觉服务,三个进程的日志分别落在 /tmp/pkh_api.log、/tmp/pkh_worker.log、/tmp/pkh_visual.log。dev.sh 只有 start / restart / stop 三个子命令。
worker 独立成进程的直接原因是视觉编码的耗时:colSmol 前向一次十几秒,6 路并发占满 8.7 个核。放进 API 进程,用户的问答就排在这些编码后面。
visual_service 独立的原因是内存:它常驻一份约 2.65GB 的 colSmol,放进 API 会让每个 API 进程都背这份内存,2C4G 的机器直接 OOM。该服务没有鉴权,因此只绑 127.0.0.1(安全边界见《运维与验收》)。
三个进程对视觉腿各有分工:
| 进程 | 编码查询文本 | 构造租户过滤 | 查询 Qdrant |
|---|---|---|---|
| API | 走远端 HTTP | 是(本地) | 是(本地) |
| worker | 本地(写侧图片编码) | — | 写侧 upsert |
| visual_service | 本地 | 否 | 否 |
后两列留在 API 侧的原因:build_qdrant_filter 是租户过滤的唯一入口,复制到另一个进程就多出第二套判定逻辑,而它漂移的方向是越权。
2. 模块依赖方向
services/api      services/mcp      services/worker
      |                |                  |
      +----------------+------------------+
      v                                   v
services/ingest  ───────────────►  services/retrieval
      |                                   |
      +----------------+------------------+
                       v
services/common| 层 | 允许依赖 | 不允许 |
|---|---|---|
common | 无(只依赖第三方库) | ingest、retrieval、api |
retrieval | common | ingest、api |
ingest | common、retrieval | api |
worker | common、ingest、retrieval | api |
api | common、ingest、retrieval、mcp | worker |
mcp | common、retrieval | api |
依赖方向直接影响写法。common/jobs.py 判断异常是否可重试用 getattr(exc, "retryable", True),没有 isinstance(IngestError)——common 不能 import ingest,否则成环,所以只能按鸭子类型读属性。
services/api/main.py 按顺序挂载 19 个路由模块。MCP 与 A2A 挂在根路径(/mcp、/.well-known/agent-card.json、/a2a/tasks),不走 /api/v1:MCP 客户端按固定路径找端点,A2A 的 Agent Card 路径是规范写死的。前端静态产物最后挂载,否则 StaticFiles 会把 /api/v1/* 全部吃掉。
routers/ 下 19 个路由模块共用一个请求级会话(common/deps.py::get_session):正常返回时提交,异常时回滚。认证也从这里进,get_current_user 解析 Authorization: Bearer sk-pkh_... 后调 load_user_context,路由代码不接触授权头。
3. 数据平面:真相与派生
| 存储 | 内容 | 是否真相 | 丢了怎么办 |
|---|---|---|---|
| Postgres | 18 张表:账号、库、文档、块、任务、审计、词表、会话 | 是 | 从备份恢复 |
| Qdrant | kb_dense、kb_sparse、kb_visual 三个 collection | 否,可重建 | 文本两腿 reindex;视觉腿重新摄取 |
本地盘 data/blobs/ | 原始文件、Office 转换预览、缩略图 | 原件本身 | 从备份恢复 |
blob 按内容寻址,路径由 sha256 决定:
data/blobs/{sha[:2]}/{sha}/original
data/blobs/{sha[:2]}/{sha}/preview.pdf
data/blobs/{sha[:2]}/{sha}/thumbs/{page}.jpg
前两位十六进制分成 256 个子目录,避免单目录堆几十万文件后 ext4 目录项退化。同一份内容被多个文档版本引用时只存一份,blobs.ref_count 记引用数,减到 0 才删目录。
3.1 Qdrant 的点 ID 与三个 collection
Qdrant 的点 ID 由三元组算出,不用自增序号:
point_id(kb_id, doc_id, chunk_index)          # blake2b-64 后右移一位
point_id_for_page(kb_id, doc_id, page_no) # chunk_index 传 -(page_no + 1)| 为什么 | 内容 |
|---|---|
| 哈希而不是自增 | 自增号随重建漂移,缓存、标注、反馈等外部引用全部错位;哈希是三元组的纯函数,同一 chunk 在任何机器、任何时刻都算出同一个号 |
| 右移一位 | Qdrant 的 id 是 uint64,但客户端链路常按有符号 64 位或更窄的数处理(JSON、protobuf int64、JS Number 只有 53 位精度)。右移一位压进 [0, 2^63),牺牲 1 bit 熵换跨语言序列化安全 |
页级点传 -(page_no + 1) | page_no 从 0 起,传 -page_no 会让第 0 页与 chunk_index=0 算出同一个号。加一之后页级点恒为负、块级点恒非负,kb_visual 里不会混进 chunk 级点 |
| 代价 | 有效空间从 64 位降到 63 位,碰撞概率翻倍,百万级点下仍在 10^-7 量级 |
| collection | 向量 | 距离 | 一个点对应 |
|---|---|---|---|
kb_dense | 512 维密集向量 | Cosine | 一个 chunk |
kb_sparse | BM25 稀疏向量,顶层 sparse_vectors.bm25 | 稀疏(内积语义) | 一个 chunk |
kb_visual | 128 维 multi-vector,命名向量 text | Cosine + max_sim 比较器 | 一页扫描件或一张照片 |
三条腿共用同一套点 ID 算法,同一个 chunk 在三个 collection 里 id 相同,RRF 融合直接靠它对齐,不需要映射表。复算的前提是 chunks 上的 UNIQUE (doc_id, chunk_index):块序号必须稳定,否则同一块会算出两个号。
4. 技术选型
| 层 | 组件 | 选型 | 说明 |
|---|---|---|---|
| API | Web 框架 | FastAPI + uvicorn | REST + SSE,契约 82 个端点 |
| 任务队列 | Postgres jobs 表 + FOR UPDATE SKIP LOCKED | 不引入 Redis/Celery | |
| 前端托管 | StaticFiles 挂 web/dist | 单机一个入口 | |
| 摄取 | PDF 解析 | pymupdf | 段落 + 表格 + 坐标,8~12ms/页 |
| Office 解析 | python-docx / openpyxl / python-pptx,预览经 LibreOffice 转 PDF | 坐标由预览任务补 | |
| 切分 | 六种策略(默认 recursive) | 详见《文档摄取》 | |
| 编码 | 文本 | BAAI/bge-small-zh-v1.5,512 维 | 进程启动即加载 |
| 视觉 | vidore/colSmol-500M | multi-vector MaxSim,worker / visual_service 加载 | |
| 精排 | BAAI/bge-reranker-v2-m3(按库启用) | 只对候选重排 | |
| 存储 | 真相源 | Postgres 16 + pgvector(装了不用)+ pg_trgm | 18 张表 |
| 向量库 | Qdrant 1.15(dense / sparse / visual 三集合) | 可重建的派生物 | |
| 原件 | 本地内容寻址目录 | 按 sha256 落盘 | |
| 前端 | React 19 + Vite 7 + Tailwind v4 | 零 CDN / 零 Web Font | 内网离线可用 |
5. 模型加载边界
三个模型各占链路的一格,不能互相替代:bge-small 做文本召回,colSmol 做页级视觉召回,bge-reranker 只对已召回的候选重排。
| 模型 | 在链路里的位置 | 体积 | 加载时机 | 谁加载 | 实测成本 |
|---|---|---|---|---|---|
BAAI/bge-small-zh-v1.5 | dense 召回:query 与 chunk 各编一次 | 约 100MB | 进程启动时 preload_core() | API、worker | 88ms/chunk,上限 512 token |
vidore/colSmol-500M | 视觉召回:一页图编成一组向量 | 约 2.65GB | 首个视觉任务或首次编码 | worker、visual_service | 加载 13s,编码 15s/图 |
BAAI/bge-reranker-v2-m3 | 精排:只重排候选,不参与召回 | — | 首次精排 | API | 114ms/对 |
精排选 m3 而不是 base 的理由:base 单对 53ms 更快,但成对判别只有 2/4 正确率,m3 是 4/4。
API 进程恒不加载 colSmol。services/api/main.py 的 lifespan 只调 preload_core(),异常不阻止启动,只写进 app.state.model_warmup_error。
worker 的加载开关有三个分支,启动日志写明走哪支:
VDR_ENABLED=false              # 不加载 colSmol。扫描件/照片不建视觉索引
VISUAL_WRITE_VIA_SERVICE=true  # 写侧走 8020,本进程不加载 colSmol(多 worker 前提)
(都不设)                      # 本地加载 colSmol
VISUAL_WRITE_VIA_SERVICE=true 之后摄取依赖视觉服务:它挂了,照片与扫描件的任务失败并重试。PKH_WORKERS=4 必须配这一项,否则 4 个 worker 各背一份视觉模型常驻内存。
HF_HUB_OFFLINE=1 与 TRANSFORMERS_OFFLINE=1 由 deploy/dev.sh 导出,换机器前先准备模型缓存。
6. 并发预算
三个实测数字推导出下面的默认值:
- 88ms/chunk:单 worker 串行编码约 11 chunk/s,
PKH_WORKERS=4约到 45 chunk/s。这是切分大小与 worker 数的调参依据。 - 15s/图:视觉摄取的真实瓶颈,因此视觉并发压到 4、单次查询超时 2s。
- 114ms/对:精排只对候选集做,候选数涨几倍耗时涨几倍,所以候选上限要小(《检索与问答》)。
一次 hybrid 检索最多占 4 条 Postgres 连接:请求自己的会话,加 dense、sparse、trgm 三条腿各自从会话工厂拿的会话。连接池不够时请求排队,延迟变差但不会算错。
| 项 | 默认值 | 依据 |
|---|---|---|
pg_pool_size + pg_max_overflow | 5 + 5 | 按并发检索数 × 4 估 |
| 视觉查询并发 | 4 | colSmol 在 CPU 上并行度 8.7x,再堆只让每条更慢 |
| 视觉查询超时 | 2.0s | 6 路并发单条 p95 905ms 的两倍余量,含排队 |
| 视觉探活缓存 | 5.0s | 每次检索都探活多一次 RTT,服务挂掉那次是连接超时 |
| trgm 语句超时 | 800ms | word_similarity 只能 seq scan,10 万 chunk 约 1.4s |
7. 关键设计决策
| 决策 | 常见的替代 | 为什么不选替代 |
|---|---|---|
| 任务用 Postgres 一张表 | Redis 队列 / Celery | 任务与业务同库,ON DELETE CASCADE 能随文档一起清掉待办;规模是几个人的团队,峰值几百条任务 |
| 三个进程分开 | 全部塞进 API 进程 | 视觉编码单页以十秒计、6 路并发吃 8.7 个核,同进程时用户提问排在编码后;colSmol 常驻进 API 会让 2C4G 直接 OOM |
| 点 ID 用三元组哈希 | 自增序号 | 自增号随重建漂移,外部引用错位,三腿还要维护映射表(见 §3.1) |
| 融合用 RRF | 分数加权求和 | 四条腿分数量纲不同,加权让数值天生大的那条腿说了算(见《检索与问答》) |
| dense 用小模型常驻 | 更大维度的 embedding | 体积小到 API 与 worker 启动时就 preload_core();它每次请求、每个 chunk 都要用,懒加载会把首次延迟打到用户请求上 |
| 精排按库启用 | 全局默认开精排 | 跨库检索时排序取决于「哪些库碰巧配了模型」,结果不可解释(见《检索与问答》) |
| 向量进 Qdrant,pgvector 装了不用 | 全部留在 Postgres | colSmol 的 late-interaction 是多向量 + MaxSim,不是 pgvector 的形状 |
| 生成层默认抽取式 | 默认接外部 LLM | 原文不出本机;接外部模型要显式配置,失败降级并写原因(见《检索与问答》) |
8. 相关文件
| 文件 | 说明 |
|---|---|
services/api/main.py | FastAPI 入口、路由注册、请求上下文、前端挂载顺序 |
services/api/static_site.py | web/dist 托管、SPA 回退白名单、缓存策略 |
services/worker/main.py | worker 主循环、进度封顶、空闲对账 |
services/visual_service/main.py | 只做编码的常驻进程 |
services/common/config.py | 全部运行时可调项与默认值 |
services/common/deps.py | 请求级会话与认证依赖 |
services/common/storage.py | 内容寻址存储布局 |
services/common/qdrant.py | collection 定义、稳定点 ID、别名与蓝绿 |
services/retrieval/pool.py | 模型池、加载统计、远端视觉服务客户端 |
deploy/dev.sh | 三进程起停、残留扫描、就绪判断 |
deploy/docker-compose.yml | Postgres 5432、Qdrant 6333/6334 |