文档摄取
一份文件从上传到 ready,中间有两次失败判定:一次在上传请求里同步拒绝,一次在 worker 里根据内容决定是重试还是终态失败。把这两次混在一起,用户会看到"上传成功但一直处理中";全都放到同步,又会让大文件把请求拖死。所以入口只做能立刻判断的事。
入口与同步校验
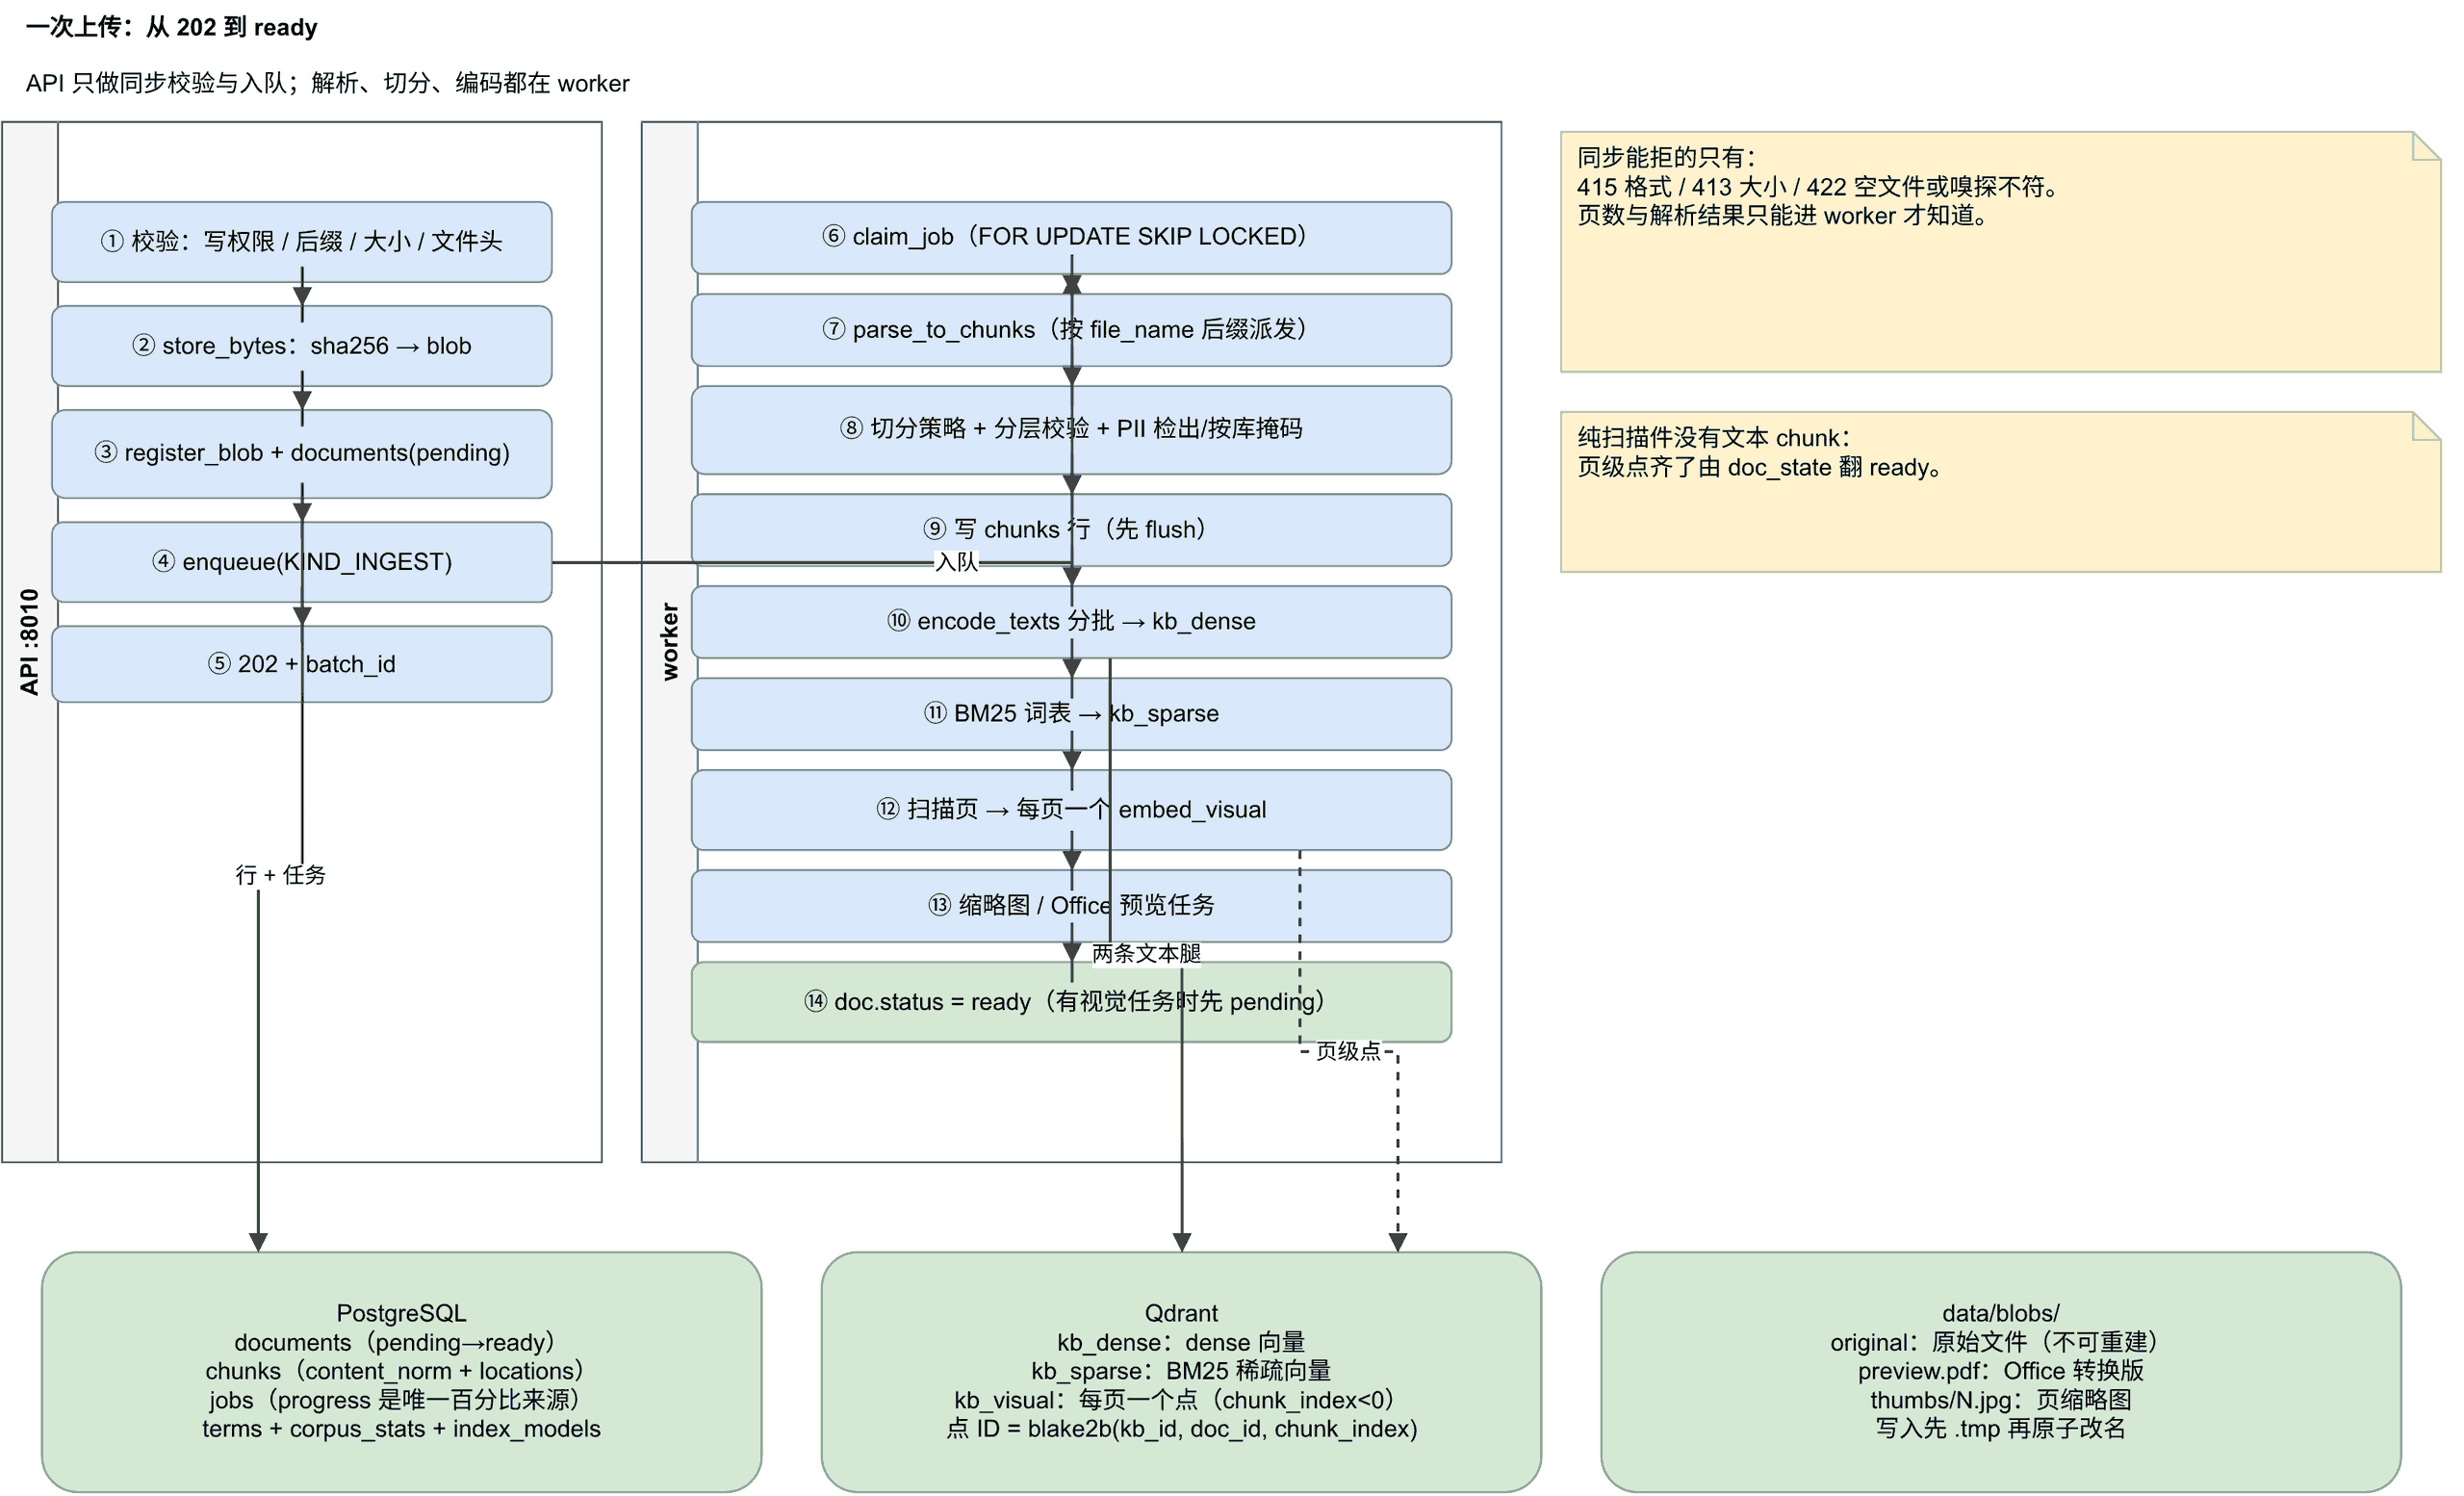
POST /api/v1/kb/{kb_id}/documents 接收 1~20 个文件。按顺序:
- 写权限:
assert_kb_write,失败与库不存在同码。 - 扩展名:不在派发表里直接 415。
- 空文件:422。
- 大小:单文件超过 50MB 返回 413。
- 文件头嗅探:只在"确凿不符"时拒绝。文本扩展名却嗅到 PDF/ZIP/图片,或声明 PDF 实际是 ZIP,才报 415;识别不出的一律放行。
这一步之后文件按 sha256 落到 data/blobs/{sha[:2]}/{sha}/original,先写 .tmp 再原子改名。blobs 行由 register_blob_async 登记,引用计数 +1。漏掉这行会直接撞 documents.blob_sha 的外键,而错误只在真正写入时出现。
同步能拒的只有这些。页数、扫描页数、解析为空、格式损坏都只能进 worker 才知道,因为要打开文件。API 返回 202,前端轮询文档列表或任务进度。
格式派发表
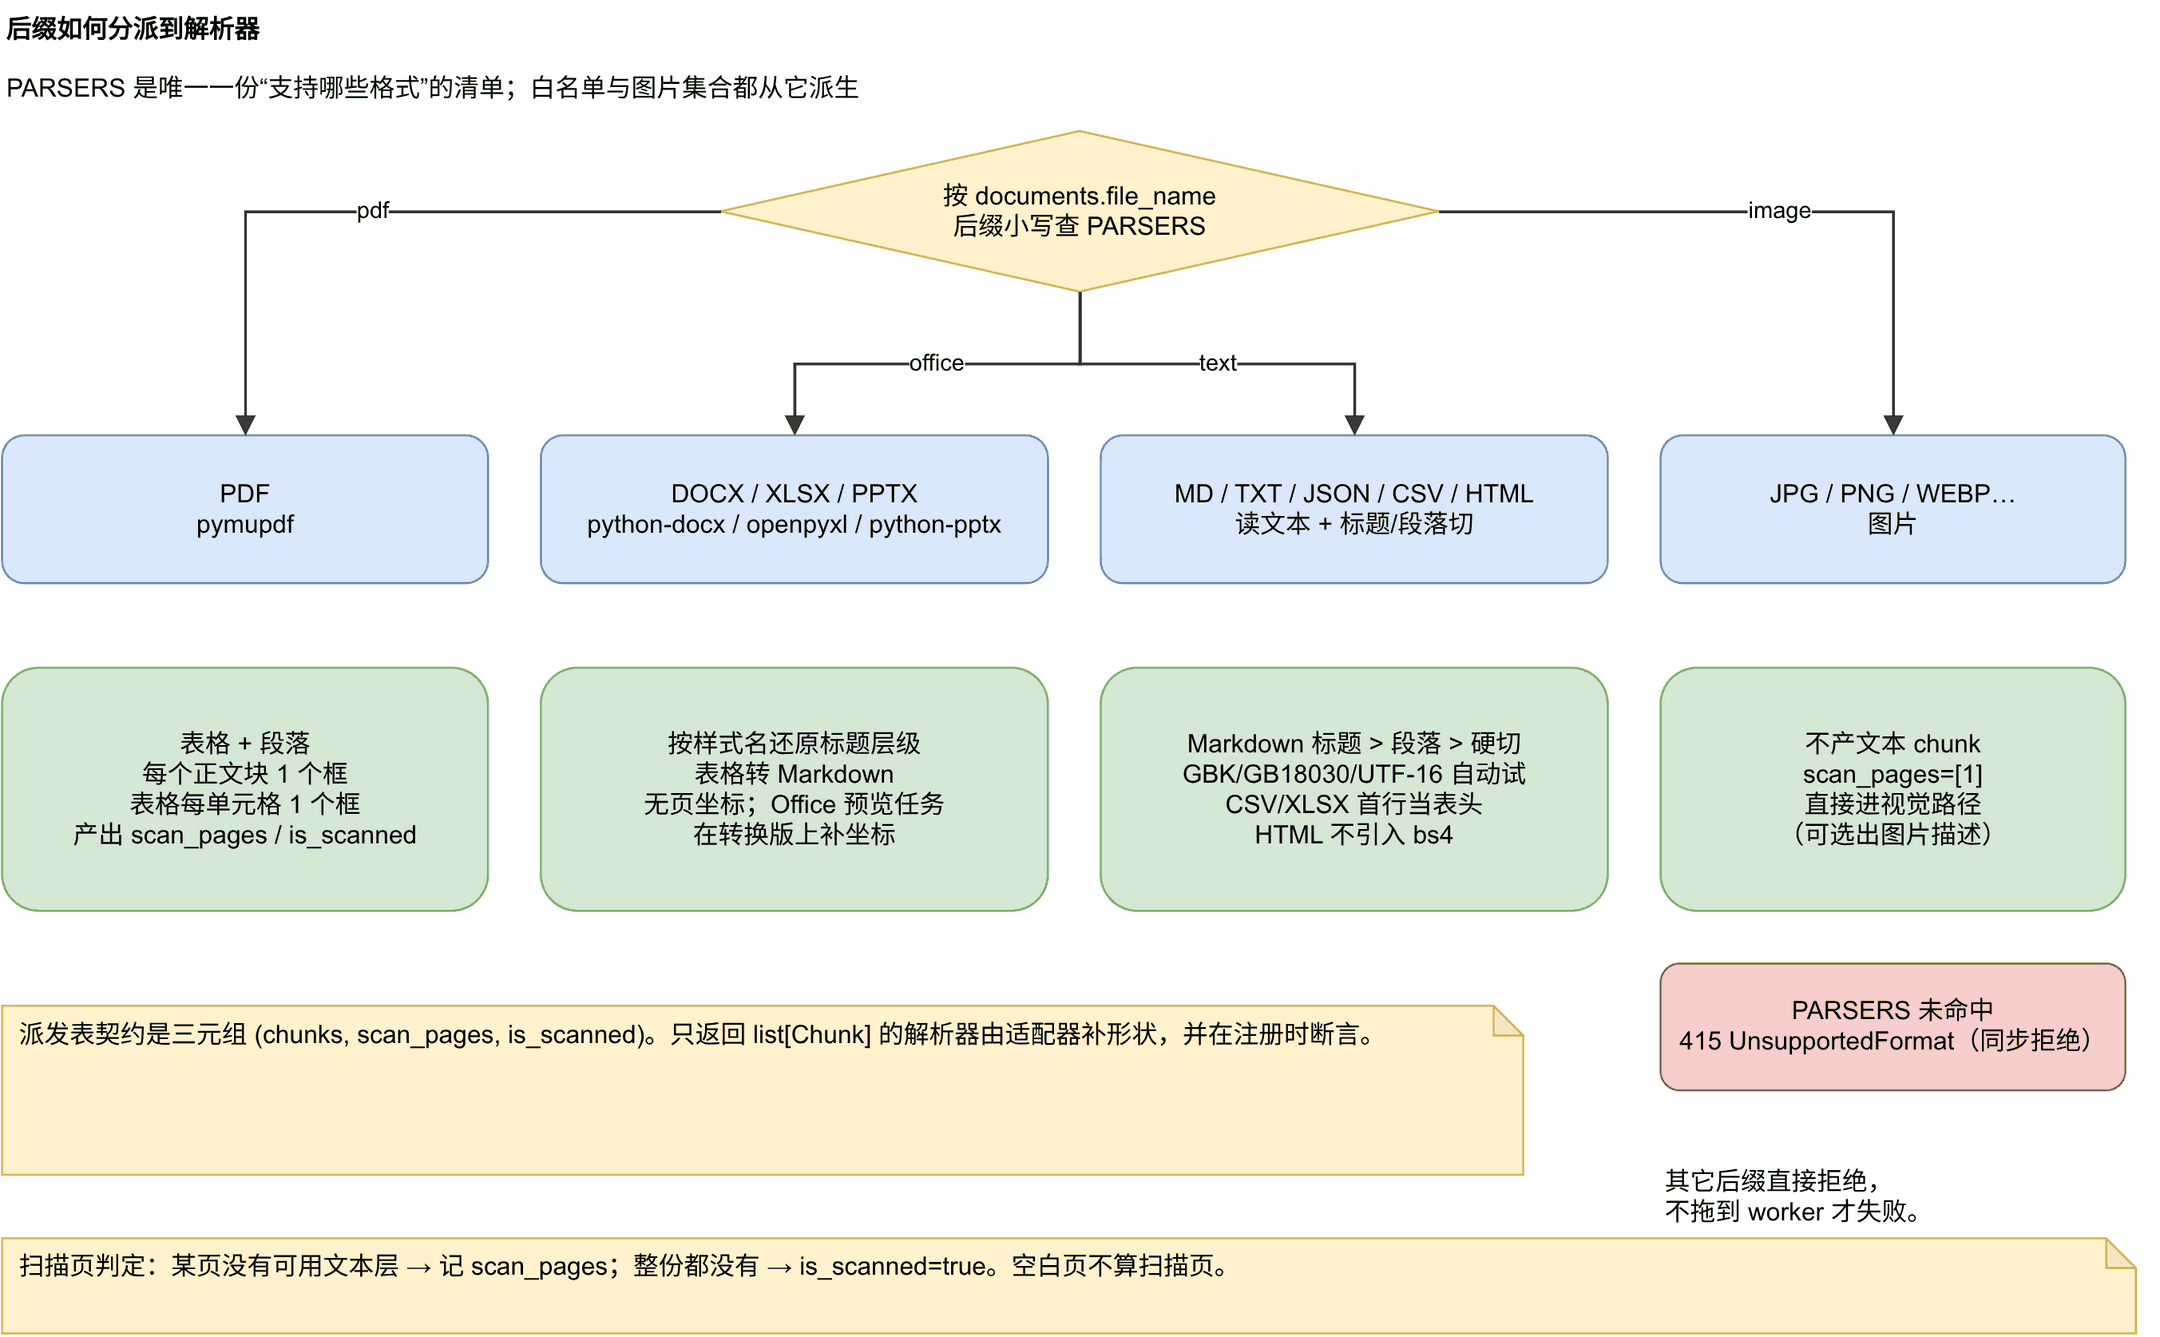
支持的格式集中在一张表里,上传白名单和解析分派都从它派生:
| 后缀 | 解析方式 | 有坐标 | 说明 |
|---|---|---|---|
.pdf | pymupdf,表格 + 段落 | 是 | 一页一页解析,表格整张一个 chunk |
.docx | python-docx | 否 | 按样式名还原标题层级,表格转 Markdown |
.xlsx | openpyxl | 否 | 每个工作表按行分组,首行当表头 |
.csv | 标准库 csv | 否 | 与 XLSX 同一套行列对齐 |
.pptx | python-pptx | 否 | 每页幻灯片一个 chunk,超长再切 |
.md .markdown .txt .json | 直接读,按标题和段落切 | 否 | 自动尝试 UTF-8/GB18030/UTF-16 |
.html .htm | 标准库 HTMLParser | 否 | 标题转 Markdown,不引入 bs4 |
.jpg .jpeg .png .webp .bmp .tiff | 不产文本 | — | 直接走视觉路径,scan_pages=[1] |
没有第二份后缀清单。以前白名单、分派、图片判断各写一份,加一种格式要改三处;漏了白名单用户能传但 worker 报"不支持",漏了分派上传直接 415。现在派发表是唯一来源,测试会断言两个派生集合确实等于从表里算出来的结果。
派发表的契约是三元组 (chunks, scan_pages, is_scanned)。只返回 list[Chunk] 的解析器由适配器补成三元组,并且在注册时断言形状;否则某个解析器改成返回三元组时会被悄悄套成 ((a,b,c), [], False)。
PDF:坐标与扫描页
PDF 的解析器不只抽文本,还产坐标。每个正文段落一个框,表格整张一个 chunk、每个非空单元格一个带 row/col 的框,坐标归一化到 0~1。前端拿到页图后乘回像素就能画框,与 DPI 无关,实测往返误差为 0。
四个容易改坏的点:
- 画框前把归一化坐标乘回 PDF point 空间,不是像素;
- 段落切分不能用全局行距常数——表格行距 4pt、正文 13.1pt,任何常数都会对一种失效;
- 段落合并必须整页收集行后统一做,这类 PDF 每行是独立 block;
- 表格框只能取
tbl.rows[i].cells,tbl.cells因合并单元格会错位。
双栏/多栏页面先按"没有行跨越的竖直切线"切列,列内再按纵坐标排;否则会把左栏结论接到右栏论据前面。页眉页脚按"同文档重复 ≥3 次且短于 40 字"删除,只在重复时删,不按"短行"猜。
扫描页判定在解析阶段做一次:某一页没有可用文本层,就记进 scan_pages;整份文档都没有文本层,is_scanned=true。空白页不算扫描页——页面上什么都没有,和"有图没字"是两回事。scan_pages 必须落库,因为它是页级视觉索引在 Postgres 侧唯一的真相来源;is_scanned: bool 说不出"该有几个点"。
六种切分
默认策略是 recursive:标题 > 段落 > 硬切。标题拼进正文,否则搜标题行命中不到内容;段落超长才硬切,切点尽量落在句末标点上。
KB 可以单选另一种策略:
| 策略 | 边界 | 编码 | 代价 |
|---|---|---|---|
fixed | 定长 + overlap | 标准 | 语义边界最弱,作评测基线 |
recursive | 标题 > 段落 > 硬切 | 标准 | 默认,行为不变 |
semantic | 句子向量相似度 | 标准 | 要跑句向量;PDF 会重排文字、破坏坐标,所以对 PDF 不执行 |
parent_child | 子块 = 递归块,父块 = 章节或页 | 标准 | 召回靠子块,生成上下文用父块 |
late | 与 recursive 相同 | Late | 整篇一次前向、按 span 池化;受 512 token 限制 |
contextual | 与 recursive 相同 | 标准 | 每块前置一句 LLM 上下文;没配 LLM 就退回 recursive 并记 note |
策略只对之后摄取的文档生效。改 chunk_strategy 不会自动重跑已有文档;库详情里的 stale_strategy_docs 数的是"还在旧策略上"的当前文档,也就是重摄取欠账。late 与 parent_child 的字段也要在重建索引时保留,否则重建会把 parent_text/table_json 一起丢掉。
任何策略抛错都退回 recursive 并记一条 note。为了试新切法让整份文档摄取失败,不划算。
体检、PII 与写入
解析后先做三层校验:
- 格式层:上传时已做文件头嗅探。
- 解析层:空内容直接
failed;乱码率超过 5%、内容过短(<100 字)或过长(>1000 万字)记进documents.quality,不阻断。 - Chunking 层:最小块 <50 字记 error,最大块 >5000 字记 warning,标准差超过均值一半记 warning。
PII 先检出再按库掩码。计数记的是掩码前原文里有几处,因为用户想知道的是"我的原文有多敏感",而不是"索引里还剩几处"。掩码只改索引侧文本,blob 原件、预览、下载仍是原文;代价是开了掩码就搜不到自己的手机号,这是按库开关时要说清的取舍。
写入顺序是:chunks 行 → dense → sparse → 记录建索引模型 → 后续任务。文本两条腿用同一个稳定点 ID,RRF 靠它对同一块。编码分批(16 个一块)不是为了省内存,是为了让进度条在长文档上真的动;一次编 74 块要 6.5 秒,其间前端什么都看不到。
纯扫描件没有文本 chunk,入队视觉任务后状态是 pending;页级点齐了由 worker 的终态判定翻 ready。VDR_ENABLED=false 时直接 ready:没有待办任务,就不该显示"处理中"。
覆盖、幂等与版本
同一个库里同名文件:
- 内容 sha 相同 → 跳过,不新建版本;
- 内容不同 → 旧行
is_current=false且deleted_at置为当前时间,新行version_id+1。
is_current 回答"哪一版参与检索",version_id 回答"这是第几版"。恢复旧版本时不会复用旧向量,一律重新入队摄取;因为期间可能改过切分参数,旧块已经过时。
聊天导入按 50 条消息切一份文档,文件名带切片序号。切片序号取"它在源文件里的位置",不是"已经建了几个文档";否则重复导入时跳过重复会让后面的编号整体前移,文件名变了、内容哈希也变了,于是每次重导都多出一批。
失败分类
IngestError 带 retryable:
- 永久错误:格式不支持、blob 缺失、解析为空、超过 2000 页、扫描件超过 50 页、页面越界。第一次就终态
failed,不占重试次数。 - 瞬时错误:网络抖动、向量库暂时不可用、Office 转换失败(可重试那一类)。回
pending,最多 3 次。
扫描件上限按"单页 15 秒"算:50 页约 12 分钟。成本是常数,与分辨率无关,因为 colSmol 内部会把长边重采样到 2048px 再切 512×512 图块;降低 DPI 一分钱都省不下来。
Office 预览是增强:转换失败只标任务失败,不动文档状态。文档照样能搜、能引用、能下载;反过来把转换失败当成摄取失败,会让人以为文件没导入成功。
边界
- DOCX/XLSX/PPTX/CSV/HTML 没有页坐标,引用只能定位到块,不能画原页框。Office 的坐标靠
pdf_preview任务在转换版上补,定位不到就不给框。 - 表格结构化只覆盖 PDF / CSV / XLSX;DOCX/HTML/PPTX 里的表格仍是纯文本。
- 解析器不做 OCR。没有文本层的扫描件交给视觉召回,不跑 tesseract。
- 新增 chunk 字段有重摄取欠账:
table_json、updated_at只对之后摄取的文档生效。