Knowledge Hub
一堆散落的办公文档、聊天记录和照片,想用一句话定位到原文里的那一页、那一句——这是这个项目要解决的问题。
它把文件收进一个单机服务:解析、切块、写入四路索引,再用带引用的问答把命中的原文递回来。默认生成层是抽取式:答案里的每一句都是从检索结果中摘出来的,所以角标能点回原文,原文也不会离开本机。接外部大模型是显式开关,不是默认路径。
30 秒架构
三个进程,两个基础设施:
| 进程 | 端口 | 做什么 |
|---|---|---|
| API(FastAPI) | 8010 | REST、SSE、MCP、A2A,并托管前端构建产物 |
| worker | 无 | 轮询 jobs 表,做摄取、视觉编码、缩略图、预览、清理、重建 |
| visual_service | 8020 | 只把文本或一页图编码成 colSmol 多向量,不查 Qdrant、不做租户过滤 |
Postgres 是权威数据源,Qdrant 是可重建的派生索引,原始文件按 sha256 放在 data/blobs/。API 进程永远不加载 2.65GB 的视觉模型;视觉查询由独立进程编码,但 Qdrant 查询和租户过滤仍留在 API 侧。
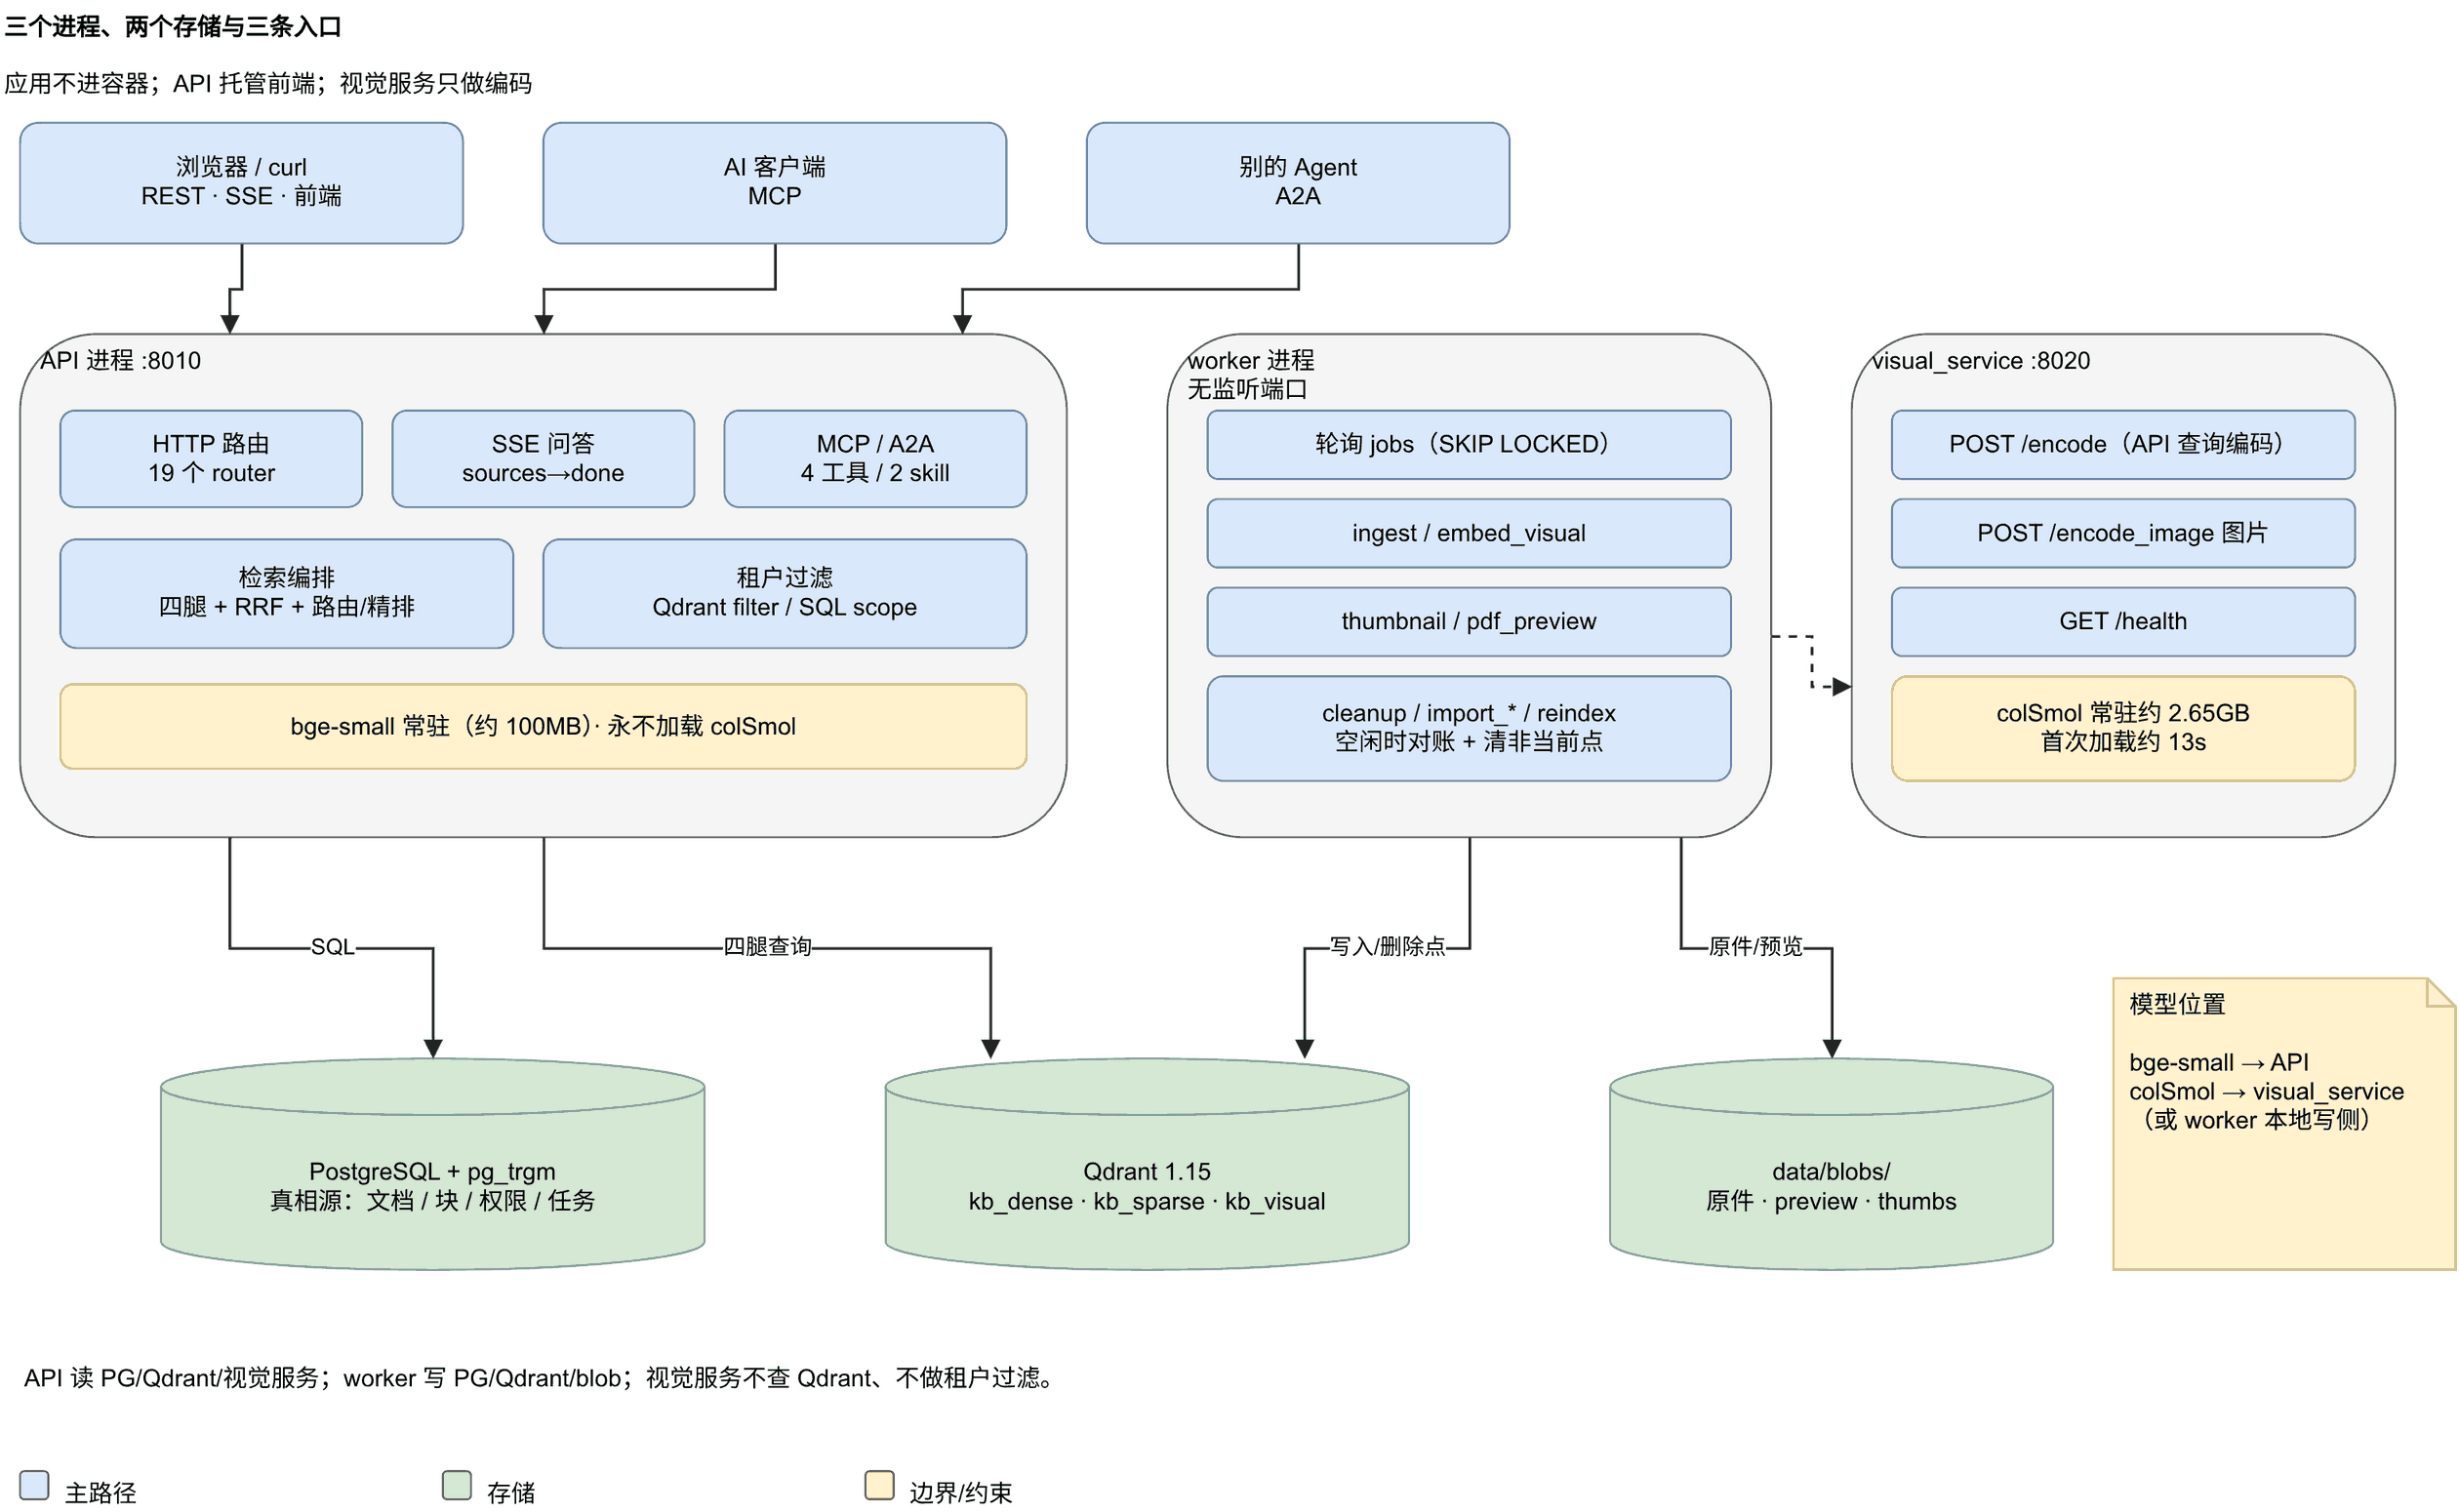
三条链路
上传到 ready。 文件先过同步校验(格式、大小、文件头),按内容哈希落到 blob,建 documents 行并入队 ingest。worker 解析出带坐标的 chunk,按库的切分策略切分,检出 PII(按需掩码),写 Postgres 与 dense/sparse 两条文本腿;扫描页另派 embed_visual,每页一个任务。纯扫描件要等页级点齐了才从 pending 翻 ready。
检索。 四条腿:dense(bge-small 中文向量)、sparse(jieba + BM25)、trgm(Postgres 字符三 gram)、visual(colSmol late-interaction)。默认 hybrid 跑前三条,视觉腿在服务可达时自动加入。每腿各自拿一个数据库会话真并发,候选池是 top_k 的三倍(上限 100),融合只用排名,不用分数。
问答。 先在开流之前完成检索、证据组装和生成器选择,然后发 sources、若干 delta、最后一个 done。流结束后另开一个事务写 user/assistant 两条消息。外部生成器超时或报错时退回抽取式,并把这个事实写进 done.degraded。
目录
services/
  api/          FastAPI 入口、19 个 router 模块、SSE、静态站点、限流
  common/       模型、认证与租户过滤、任务、存储、Qdrant、对账
  ingest/       解析器派发表、PDF 坐标、六种切分、校验、PII、清理
  retrieval/    四腿、RRF、路由、精排、改写、生成器、模型池
  worker/       同步任务循环、8 种 handler、文档终态判定
  mcp/          JSON-RPC 协议与 4 个工具
  visual_service/  独立编码进程
web/            React 19 + Vite 7 + Tailwind v4
migrations/     23 个迁移;当前模型 18 张表
eval/           契约检查、三套 HTTP 验收、检索/生成回放
deploy/         起停、CI 门禁、巡检、备份恢复、蓝绿迁移
起服务
基础设施只有两个容器:
docker compose -f deploy/docker-compose.yml up -d
bash deploy/dev.sh start          # API 8010 + worker + 视觉服务 8020
bash deploy/visual.sh status      # 视觉服务单独管理
改过后端代码用 bash deploy/dev.sh restart。只杀进程组 leader 杀不干净 uv run 派生的子进程,残留的旧 worker 会继续用旧代码领任务,症状是"改了没生效"。
前端由 API 托管,构建一次即可:
cd web && npm run build
首次没有账号时,自助注册默认开着;关掉之后用 uv run python -m services.api.scripts.create_user 建号。演示照片库用 uv run python deploy/seed_photos.py。
验收
全量基线需要真实 Postgres(pgvector)、Qdrant 和本地缓存的模型;CI 只跑不需要这些依赖的那一部分:
uv run pytest                       # 1335 项
uv run python eval/contract_check.py --strict
uv run python deploy/monitor.py     # 12 个检查函数,报告通常 14 项
cd web && npm test                  # 316 项
bash deploy/ci.sh                   # 免基础设施门禁
三套 HTTP 验收(1b/1c/1d)要起服务;1c/1d 还需要一份本地多页 PDF。它们的项数与依赖见测试与验收。
文档地图
| 文档 | 回答什么 |
|---|---|
| 架构与进程 | 三个进程各管什么?边界为什么这么划? |
| 文档摄取 | 一份文件从上传到 ready 经过哪些步骤? |
| 检索 | 四条腿怎么召回、怎么融合、怎么降级? |
| 问答 | SSE 怎么发?证据怎么排?引用怎么校验? |
| 数据与一致性 | 哪些是真相、哪些可重建?删除链怎么走? |
| 多租户与权限 | 可见性在哪里判定?为什么只有两个入口? |
| 任务与运维 | 任务状态机、巡检、备份、重建怎么用? |
| 对外接口 | HTTP、MCP、A2A 怎么共用一套内核? |
| 测试与验收 | 测试分几层?各层能抓到什么? |
| 失败模式 | 出问题时先看哪里?哪些失败是静默的? |
| API 契约 | 端点、错误码、分页与 SSE 字段 |
已知限制
- 不做 OCR:扫描件没有文本层时不走 tesseract,交给视觉召回。
- 默认不做归纳:抽取式只给原句;要归纳就得配外部 LLM,而原文会离开本机。
- Late Chunking 受 512 token 限制:
bge-small的上下文上限,超长文档的"整篇注意力"只在窗口内成立。 - 新字段有重摄取欠账:
table_json、updated_at只对之后摄取的文档生效;旧文档要重新摄取才带上。 - 表格结构化只覆盖 PDF / CSV / XLSX:DOCX、HTML、PPTX 里的表格仍按纯文本处理。
- 视觉服务没有鉴权:只绑
127.0.0.1,不要指到0.0.0.0;不装时把VISUAL_SERVICE_URL留空,视觉腿会如实标skipped。 - 存储只有本地盘:对象存储的触发条件是"要上第二台机器 / 备份要出本机"。