knowledge-hub
检索
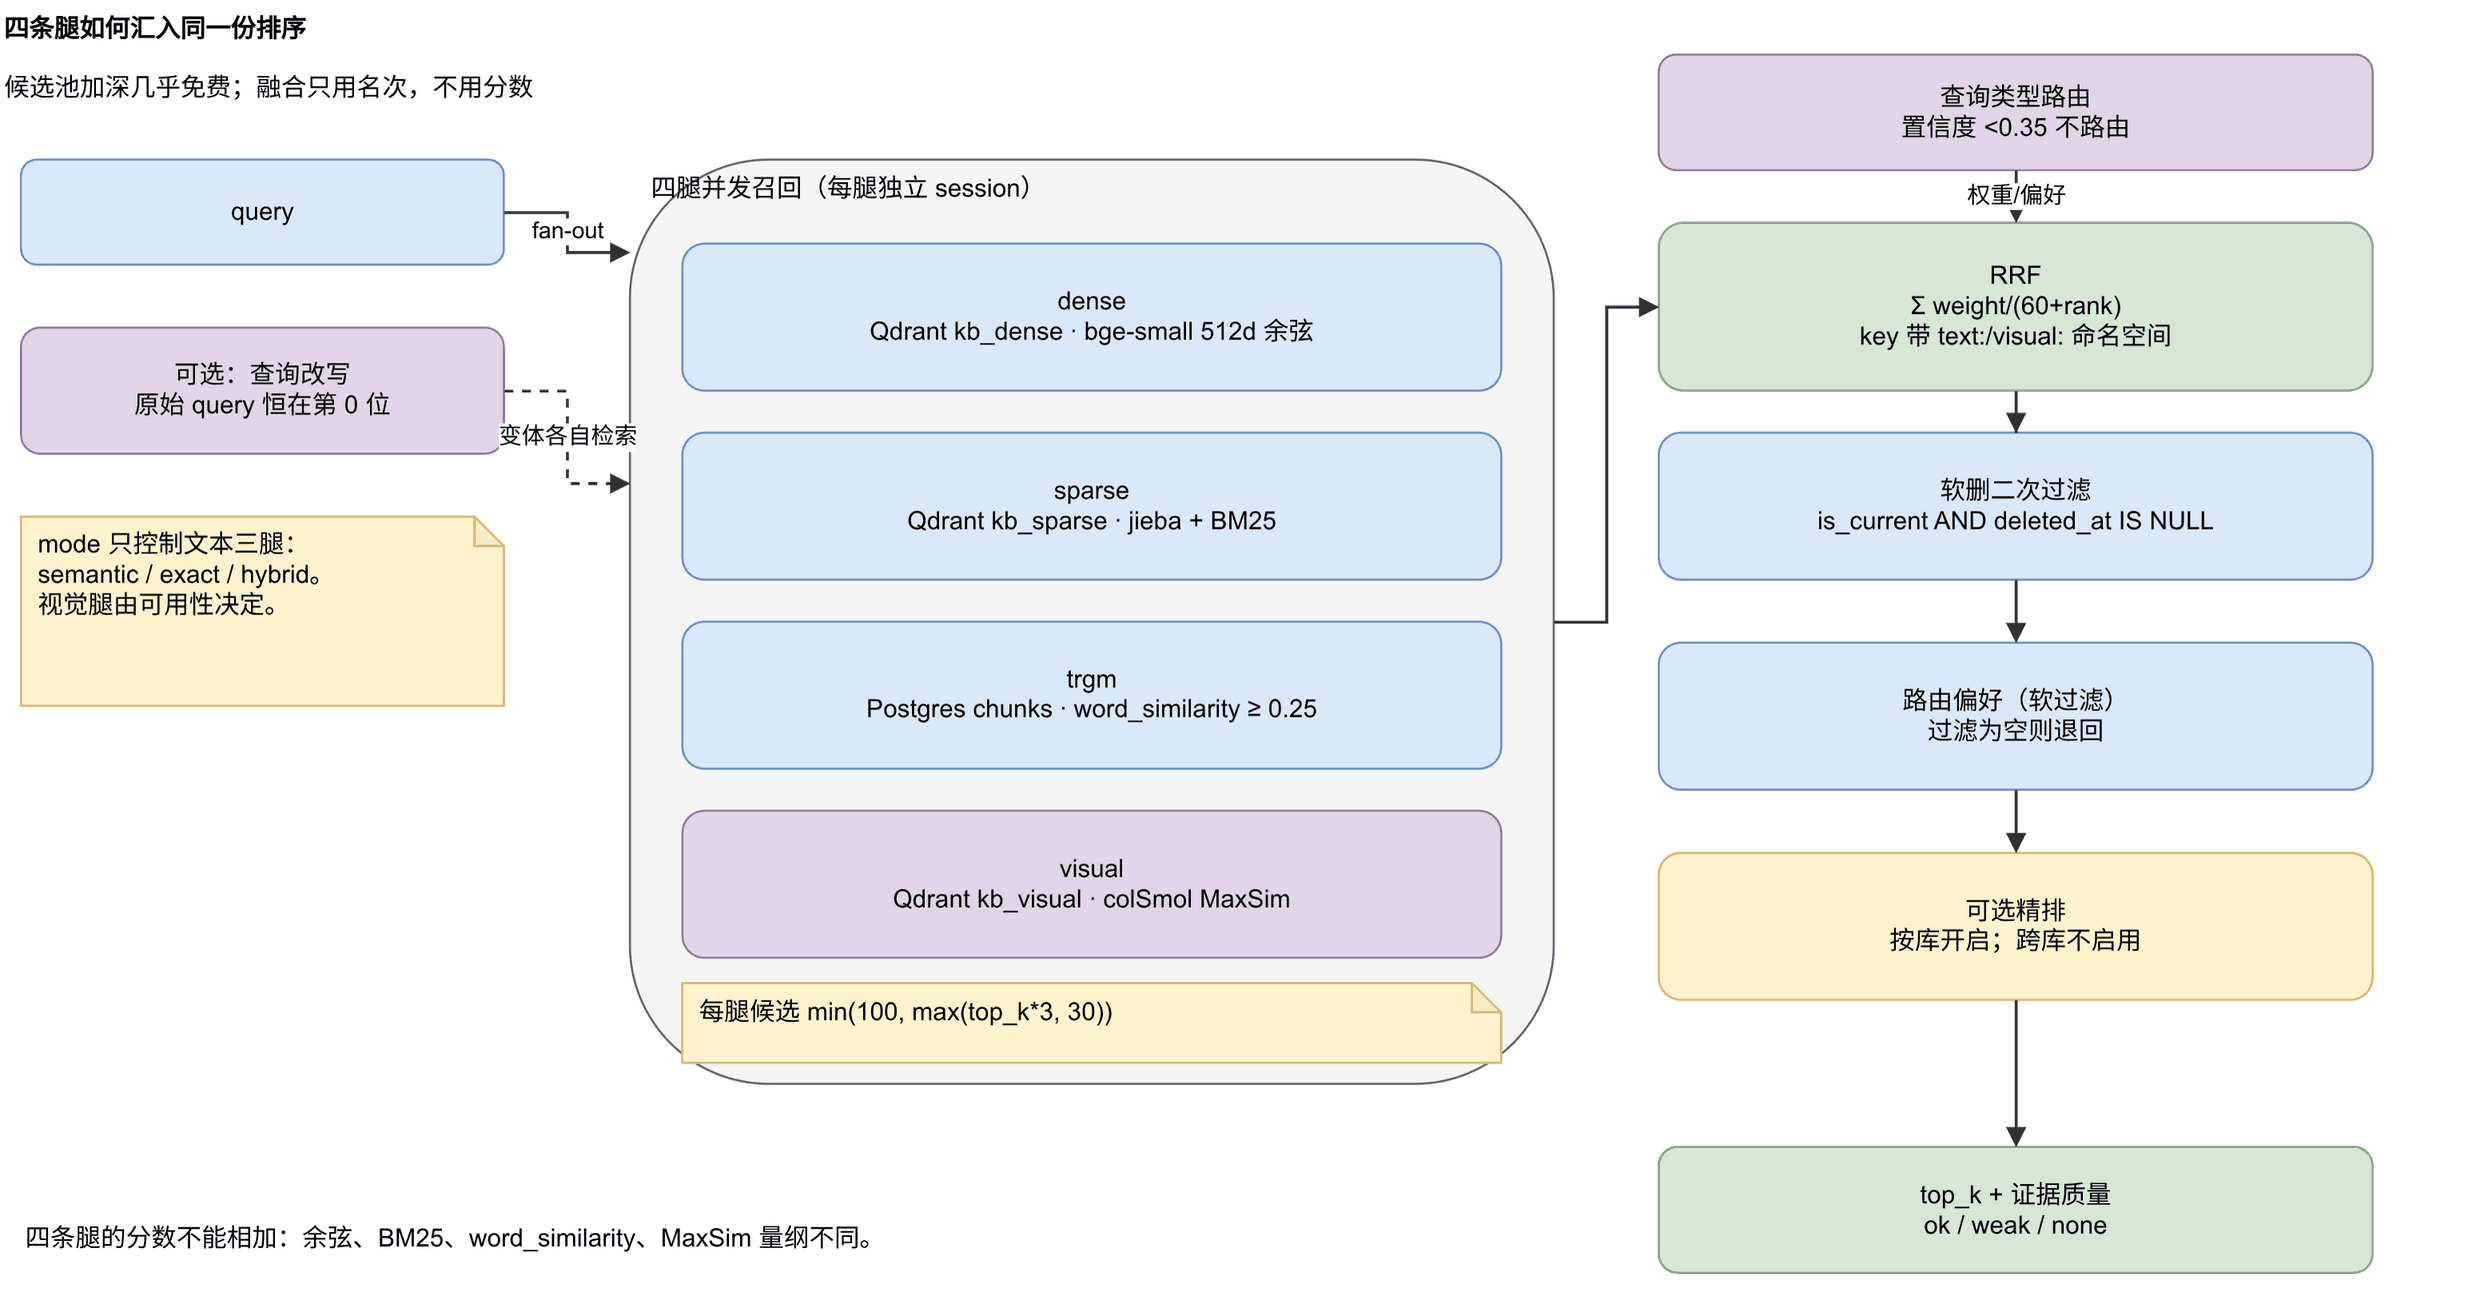
检索要回答的不是”哪段文字和问题最像”,而是”在这批资料里,哪几条最可能包含答案,而且我能说清为什么”。这两件事不一样。向量相似度对同义表达友好,却对手机号、错误码、人名、日期这类字面量无能为力;BM25 对词元精确,但中文分词一断错就全盘皆输;字符三 gram 能兜住非词字符串,却读不懂语义;视觉索引能找回照片和扫描页,却召不回纯文本。四条腿各有各的盲区,所以先让它们各自召回,再融合。
四条腿各答什么
| 腿 | 存储 | 查询怎么来 | 强项 | 已知弱项 |
|---|---|---|---|---|
| dense | Qdrant kb_dense |
bge-small 编码查询,512 维余弦 | 语义泛化、博客类 | 按日期提问、编号/错误码 |
| sparse | Qdrant kb_sparse |
jieba 分词 + BM25 查询侧权重 | 关键词、人名、聊天、日期归一化 | 非词字符串、OOV |
| trgm | Postgres chunks |
word_similarity(q, content_norm) >= 0.25 |
子串、手机号、工号、错误码 | 只能 seq scan;自然语言召回窄 |
| visual | Qdrant kb_visual |
colSmol 查询编码,多向量 MaxSim | 照片、扫描页 | 对纯文本类 query 天然召不回 |
mode 只控制前三条:semantic 走 dense,exact 走 trgm,hybrid(默认)走 dense + sparse + trgm。视觉腿不受 mode 控制,由 visual_available() 决定是否加入:本地进程启用了视觉模型,或远端视觉服务可达且模型就绪。
并发与候选池
每条数据库腿各拿一个会话,四条腿用 anyio.gather 真并发。共用调用方的 AsyncSession 会踩 SQLAlchemy 的并发限制:This session is provisioning a new connection; concurrent operations are not permitted。更糟的是它的表现——sparse/trgm 被记成 skipped,hybrid 静默退化成 dense 单腿,检索仍然 200,debug 面板也不报错。
代价是连接数。一次 hybrid 最多占”请求会话 + 3 条腿”四条连接;连接池要按并发检索数 × 4 估。单机个人库默认 5+5 足够,高并发部署要调大;池不够时请求排队,延迟变差但不至于算错。
每腿取多少候选:min(100, max(top_k*3, 30))。取浅了真值可能在第 11 名,取深了只多付每腿的 limit;而查询编码只做一次,加深几乎免费,所以加宽候选比调融合公式更划算。
RRF 为什么只用排名
四条腿的分数量纲完全不同:dense 是 0~1 的余弦,sparse 是随语料增长的无界 BM25 分,trgm 是 0.25~0.40 的窄带小数,visual 是 MaxSim。要加权求和就得先归一化,而归一化要么依赖单次查询的候选集(min/max),要么被某条腿的离群值带跑(z-score)。同一个 chunk 换一句问法就会换一个分数,排序跟着抖。
RRF 只看名次:
score(d) = Σ_leg weight_leg / (60 + rank_leg(d))
k=60 是原论文取值。它让第一名与第二名的分差只有约 0.26%,一条腿的头部优势压不过两条腿的共识——dense 和 sparse 都排第一的块,应该赢过”只有一条腿排第一、另一条腿排第 30”的块。
两个实现细节不能省:
- key 带命名空间。文本块与页级点的 ID 空间独立,直接拿点 ID 做 key 会让”文本 chunk 3”和”扫描页 3”互相抵消。文本用
text:<id>,视觉用visual:<id>。 - 排序要有确定性 tiebreaker。RRF 分是浮点,并列时不给
key作次序,同一个 query 两次请求的顺序会变,前端引用角标[1][2]刷新后会对调。
跳过的腿不参与分母。视觉腿不可用时如果按”排了第 0 名”塞进去,会稀释所有结果;它没跑就是没跑。
路由:按问题类型换权重
等权 RRF 在分类别评测里没有赢过任何一类的最佳单腿。聊天类 sparse 1.00、dense 0.10;照片类文本三腿全 0、visual 1.00。一条固定权重不可能同时是这两类的最优。所以问题不是 k 值,而是”该按 query 类型换一套权重”。
路由是规则匹配,六类意图:
| 意图 | 触发词示例 | 动作 |
|---|---|---|
photo |
照片、图片、合影、拍的 | visual 权重 3.0,偏好 photo 库 |
scan |
扫描件、影印件、拍下来的那份 | visual 2.0 + sparse 1.2,偏好 page/table |
table |
哪一栏、怎么填、表头、单元格 | sparse 1.3 + trgm 1.2,偏好 table |
chat |
聊天、他说、提过、记不记得 | sparse 1.6,偏好 chat 库与 chat 块 |
date |
哪天、什么时候、去年、纪念日 | sparse 2.5;日期字面量本身也算 date |
general |
其余 | 等权,不过滤 |
三条纪律:
- 拿不准就不路由。置信度低于 0.35 退回等权,与引入路由前完全一致。宁可少优化,也不要用一个猜错的意图把结果过滤空。
- 偏好是软过滤。按 kind 或库类型过滤后如果为空,退回未过滤,并在
note里说明”库里没有这类结果”。 - 只调权重与偏好,不调 k。k 是对排名尺度的定义,不是分类器旋钮。
photo 的 3.0 是实测出来的,不是拍的:视觉权重 2.0 时融合池里 10/20 是照片,3.0 时 20/20、top10 里 10/10,再往上没有收益。这里还有一个容易误读的机制:权重决定”哪些结果能进融合池”,偏好只能重排已经在池里的。所以库比 top_k*2 小时,权重调多少看起来都一样。
精排与证据质量
精排默认关闭,按库开启(kb.rerank_model 非空)。它拿到的是 RRF 之后的候选,只能重排、不能召回;真值不在候选里就救不回来。CPU 上 base 每对 (query, doc) 约 30~60ms,默认的 v2-m3 约 114ms;20 个候选就是 1~2 秒量级,所以它不是默认路径。
不可用时返回 skipped 并保持原顺序,不静默降级。排序键是 (-score, index),同分保持原 RRF 顺序;这一点写成显式键,而不是依赖 sorted 恰好稳定。跨库检索一律不启用精排——不同库可能配了不同模型,排序会取决于”哪些库碰巧配了”。
证据质量用 RRF 自己的信号判三档:
| 档位 | 条件 | 含义 |
|---|---|---|
none |
没有任何命中 | 硬拒答:没有证据 |
weak |
头部最强证据只来自一条腿 | 单腿排序,可信度低 |
ok |
头部最强证据有 ≥2 条腿认可 | 正常 |
它不改变抽取式的行为(抽取式自己会在摘不出句子时拒答),但给外部 LLM 一个可依赖的”证据不足”信号:none 且不是抽取式时,直接拒答,不调模型。
降级清单
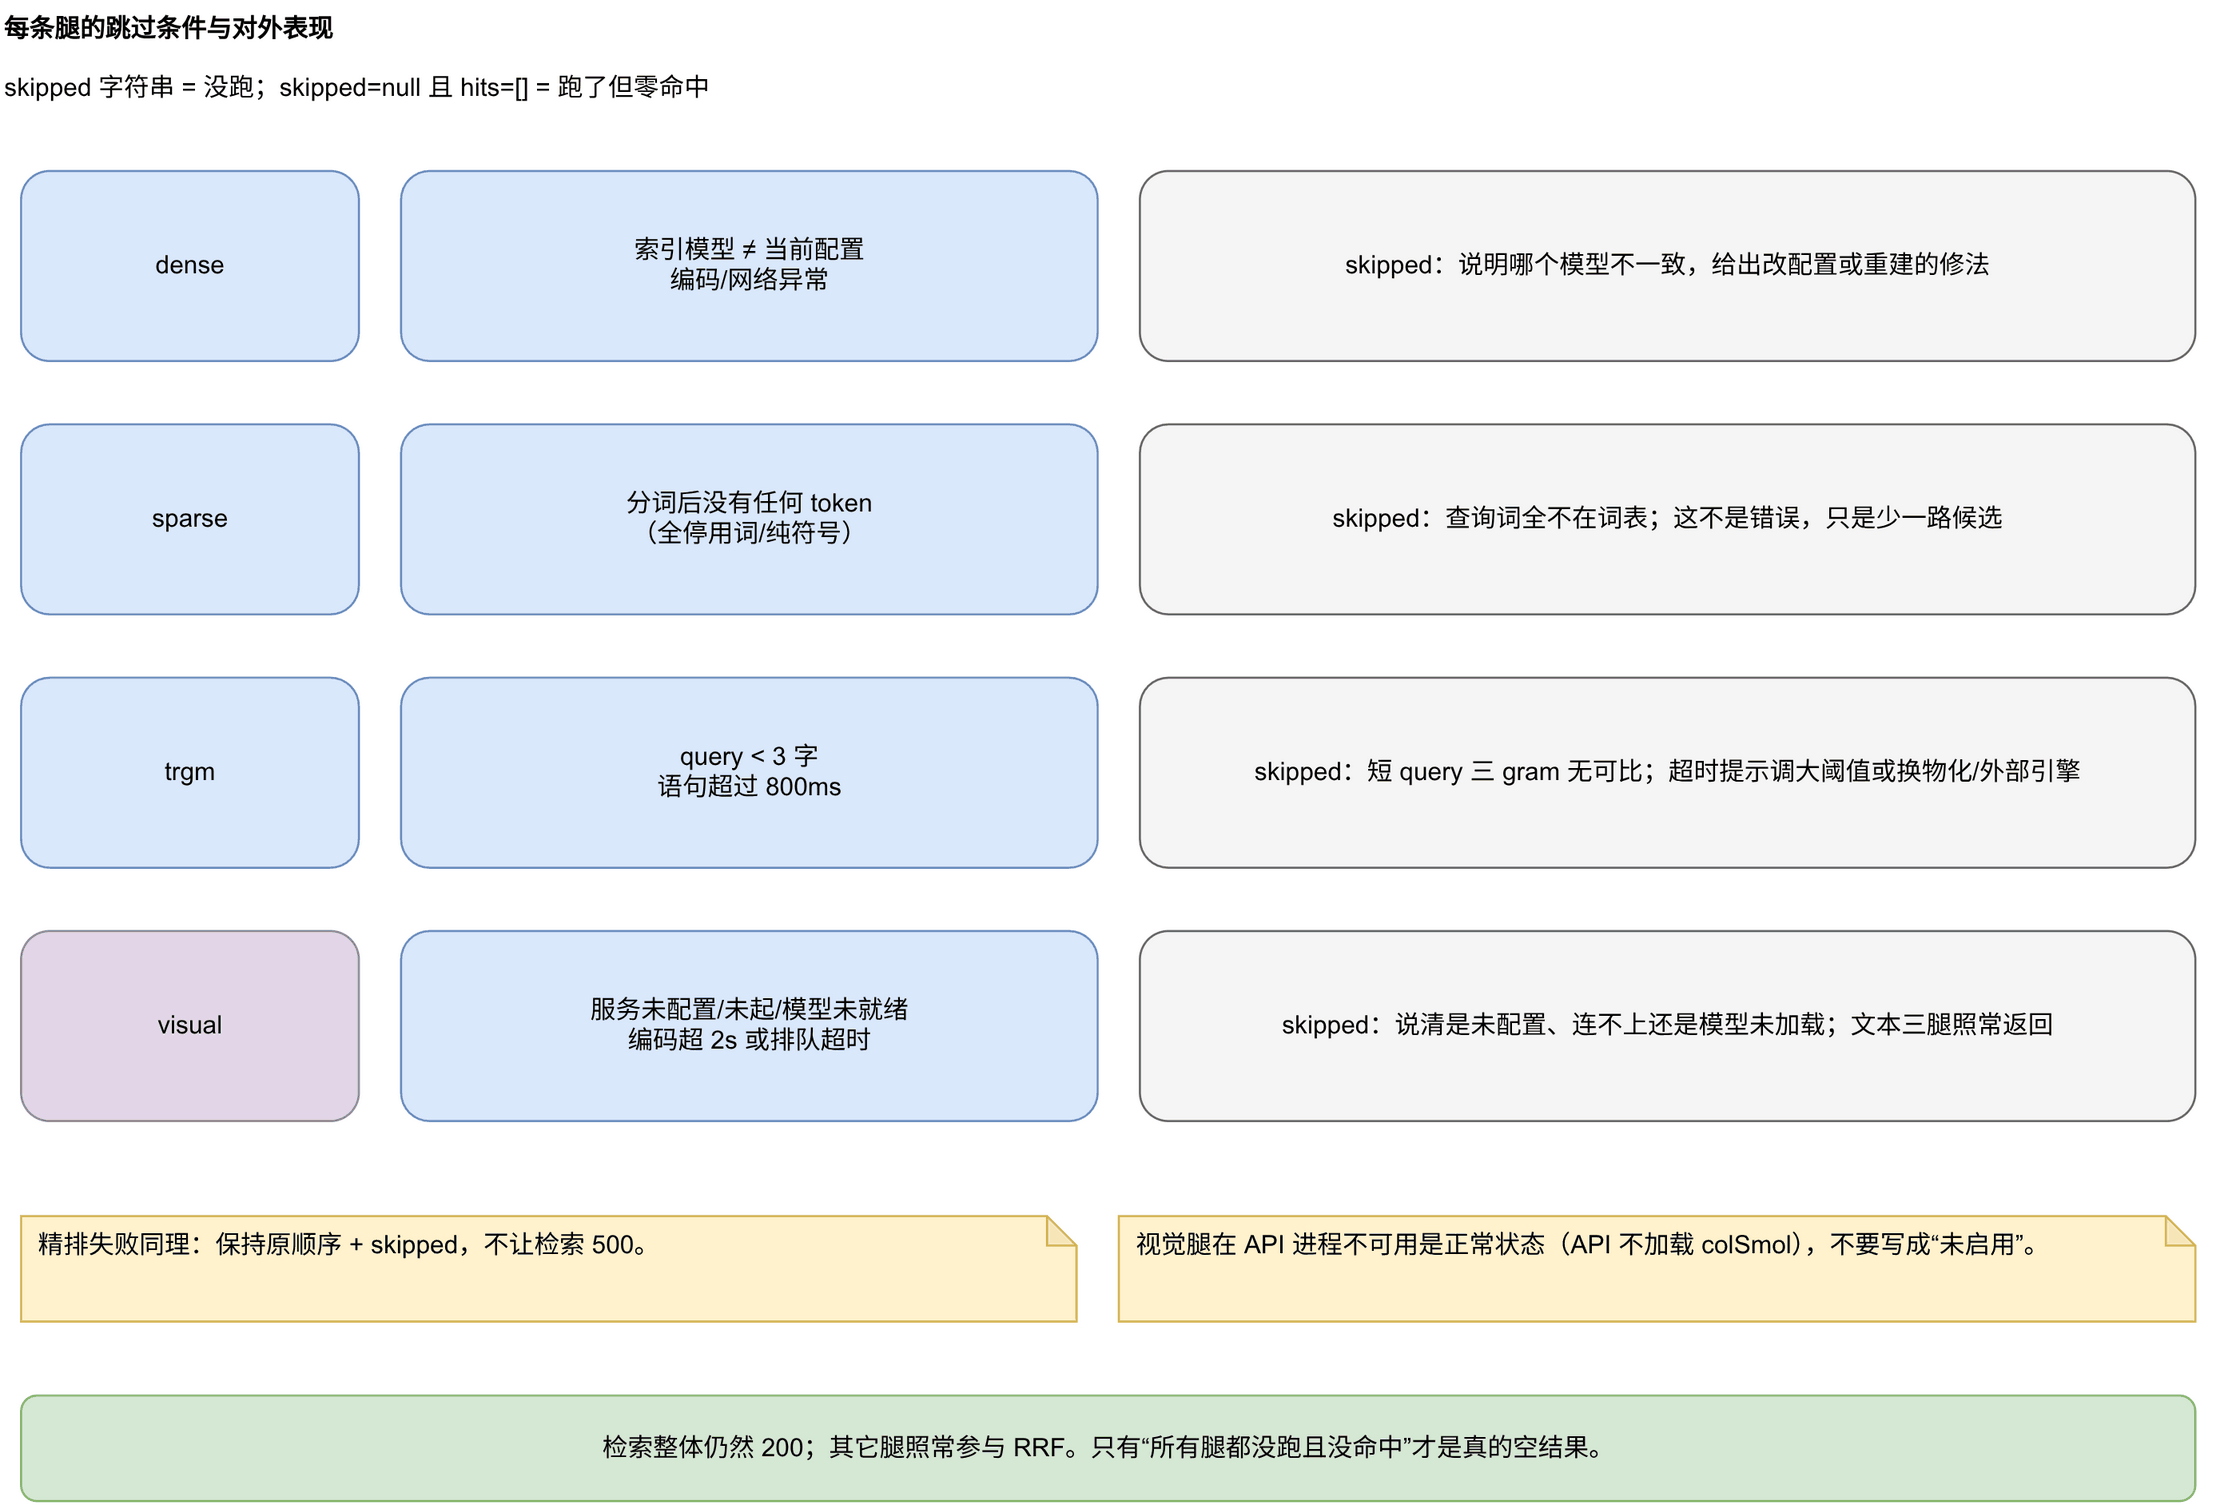
| 情况 | 这条腿的结果 | 检索整体 |
|---|---|---|
| 视觉服务未配置/未起/模型未加载 | skipped + 可操作原因 |
200,文本三腿照常 |
| 视觉编码超 2s 或并发排队超时 | skipped |
200 |
| dense 索引模型与当前配置不一致 | skipped + 修法 |
200,其它腿照常 |
| sparse 查询词全不在词表 | skipped(OOV 不是错误) |
200 |
| trgm 超过 800ms 语句超时 | skipped + 调参指引 |
200 |
| trgm query 短于 3 字 | skipped |
200 |
| 精排模型加载失败/推理失败 | skipped,保持原顺序 |
200 |
| 单腿抛异常 | skipped |
200 |
skipped 的文案必须能照着修。只写”失败”会让人查错方向:视觉腿在 API 进程不可用是正常状态,因为 API 从不加载 colSmol;把它说成”未启用”会让人去 API 里找一个不存在的开关。
实测与调参边界
38 条人工标注 query、chunk 级真值,2026-10-15:
| 腿 | Hit@1 | Hit@5 | Hit@10 | MRR |
|---|---|---|---|---|
| dense | 0.3158 | 0.6316 | 0.7368 | 0.4543 |
| sparse | 0.4211 | 0.7632 | 0.8421 | 0.5630 |
| trgm | 0.2368 | 0.3158 | 0.3947 | 0.2871 |
| hybrid | 0.5000 | 0.7368 | 0.8421 | 0.5948 |
| hybrid + rewrite | 0.5526 | 0.7105 | 0.8421 | 0.6393 |
照片类 8 条:文本三腿全 0,visual Hit@1 0.75 / Hit@5 1.00;扫描件 4 条:文本三腿全 0,visual 1.00/1.00。所以整体数字不能拿来做取舍,只有分类别数字可比——照片题的 0 分不是”检索坏了”,是文本腿本来就不该召回照片。
调参的顺序应该是:先看分类别哪条腿最强,再看路由有没有把 query 分对,最后才看融合权重。直接调 RRF 的 k 或给 sparse 乘一个系数,解决不了”照片不在文本候选里”这种召回层面的缺口。
一个已知的取舍
trgm 腿只能走全表扫描。word_similarity 用不上 gin_trgm_ops;试过 ILIKE '%整句%' 和整段 similarity(),前者要求 query 是原文连续子串,后者对 500 字 chunk 恒在 0.05~0.11,两种都漏召回。漏召回比慢更难发现——用户只会觉得”搜不到”。所以这一腿保留 seq scan,用 800ms 语句超时兜住大库;真扛不住时的正解是物化 token 集合或换外部搜索引擎,不是把召回条件换回 ILIKE。
word_similarity 与 similarity 只差一个词,排序结果完全不同:对 8 字提问、500 字 chunk,similarity() 的 top1 是一段偏离答案的表格标题(0.111),word_similarity() 的 top1 才是含答案的那段(0.400)。用错不报错,只会稳定地排错序,所以这里有一条单测把编译出的 SQL 钉住。