knowledge-hub
任务与运维
这个项目没有消息队列、没有 k8s、没有 APM。单机自部署的默认假设决定了运维方式:任务表就是 Postgres 的一张表,巡检就是一条能随手跑的命令,备份只备”事实”,索引靠重建。理解这一点,很多”看起来该有的组件”就不该出现。
任务从哪来
八种任务:
| kind | 谁入队 | 成本 | 说明 |
|---|---|---|---|
ingest |
上传、恢复、重解析、重试 | 约 50ms/页 + 88ms/chunk | 解析→切分→嵌入→写文本两腿,一次做完 |
embed_visual |
摄取时按扫描页/照片 | 约 15s/页 | 一页一个任务,不能和 ingest 合并 |
thumbnail |
PDF 摄取后 | 约 30ms/页 | 前 20 页,宽 400px |
pdf_preview |
Office 文档摄取后 | 0.7s 起,大 PPT 可 30s+ | LibreOffice 转 PDF,顺带补坐标 |
cleanup |
删库后 / 定时 | 变量 | 30 天到期清理、容器清理 |
import_chat |
POST /kb/import/chat |
分钟级 | 聊天 jsonl 切片成文档 |
import_dir |
POST /kb/{id}/import/dir |
分钟级 | 服务器目录里的图片批量入库 |
reindex |
POST /admin/reindex |
分钟级 | 重建词表与两条文本腿 |
视觉任务必须独立,原因是成本:colSmol 单页 15 秒,塞进 ingest 会让一次上传的进度卡在 90% 很长时间,而且 API 侧看不到”是在编码还是在解析”。
状态机
jobs.status:pending → running → done / failed / cancelled。
- 入队去重按
(doc_id, kind, payload)。视觉任务一页一个,payload 是{"page": n},去重必须比 payload;只比(doc_id, kind)会让 3 页扫描件只入队第 1 页,另两页永远不编码,而任务状态全是done、日志干净。 - 领取用
SELECT ... FOR UPDATE SKIP LOCKED,先找pending;没有就接管locked_at超过 15 分钟的running。租约超时要大于单个任务最长耗时;视觉任务实际会周期性心跳续租,15 分钟只是兜底。 - 心跳把
progress和业务计数器写进jobs,走独立事务,主任务还在跑时/jobs就能读到。payload 用 JSONB 浅合并,不覆盖用户下发的参数。 - 结算:成功
done+progress=1.0;失败时如果异常可重试且attempts < max_attempts(3),回pending,否则failed。IngestError.retryable=False的永久错误第一次就终态,不浪费重试。 - 取消:删文档/覆盖版本时把未完成任务置
cancelled。 - 进度上限:handler 上报的进度封顶 0.999,
1.0只归finish_job。否则会出现running + progress=1.0的瞬间,前端以为完成了,任务其实还在收尾。
文档终态
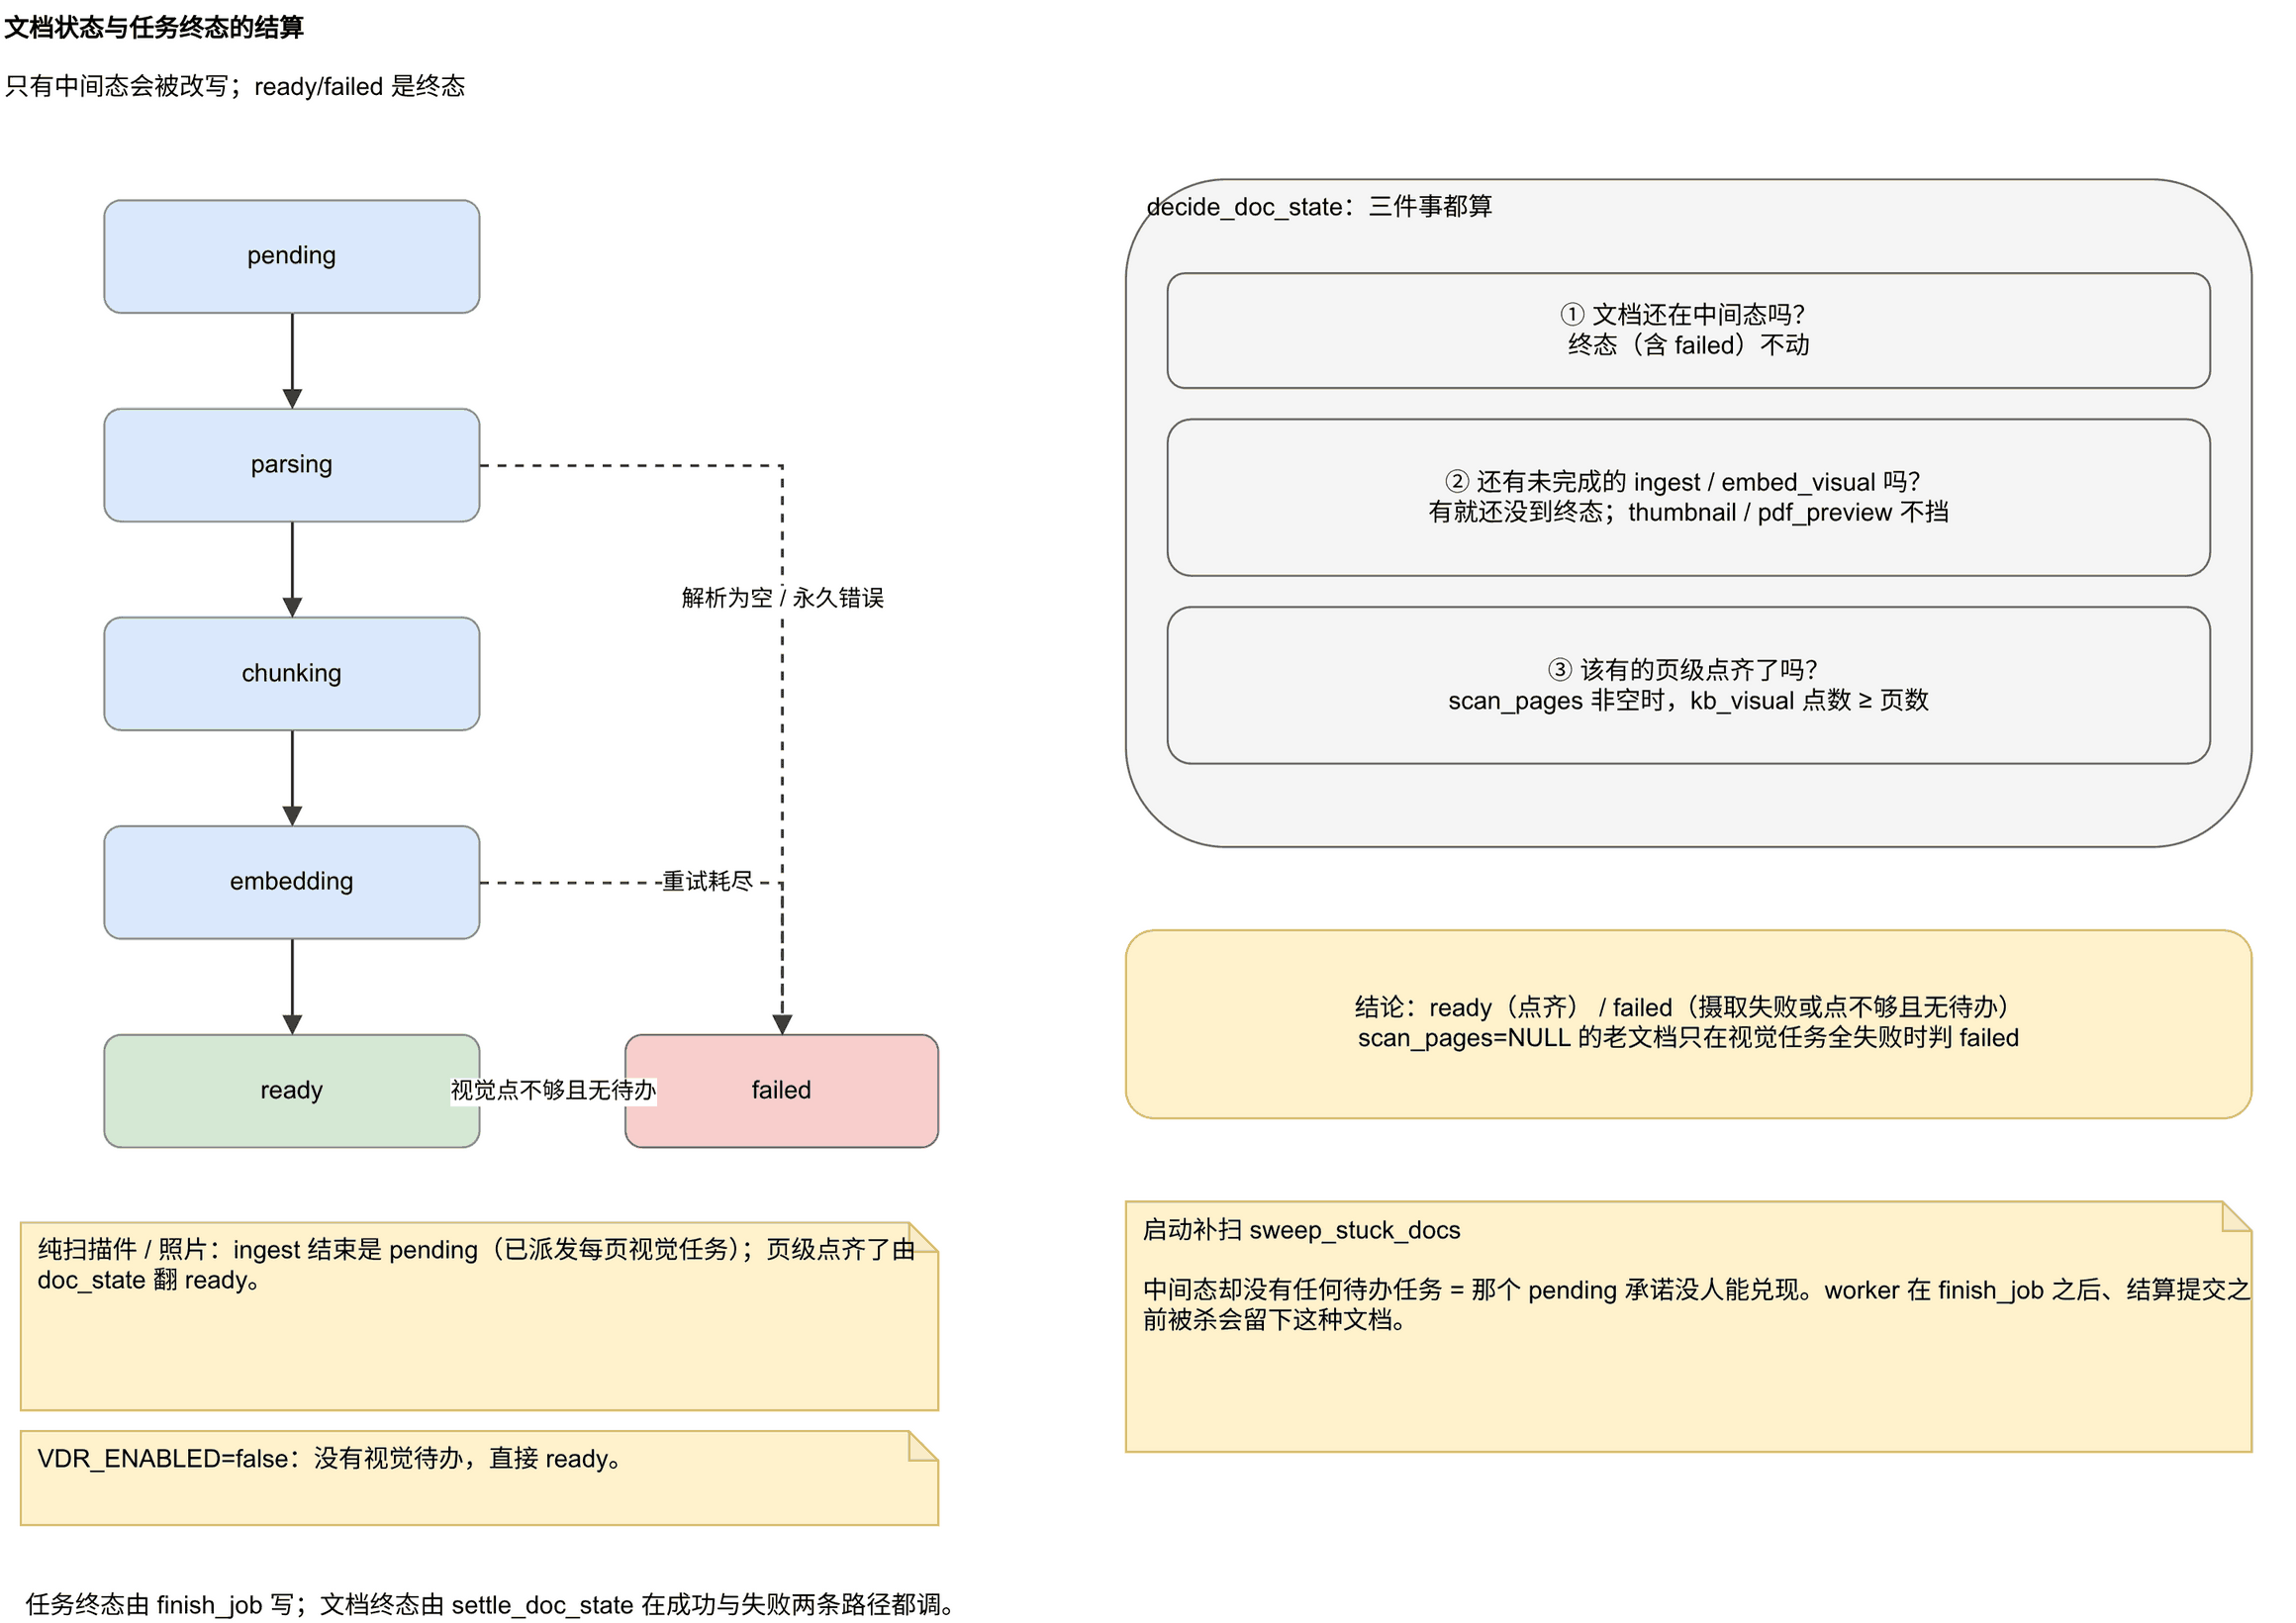
jobs.status 与 documents.status 是两份状态。任务到终态后,worker 调 settle_doc_state 把结论搬给文档;失败路径也调,不只成功路径。
判定看三件事:
- 文档是否还在中间态(
pending/parsing/chunking/embedding)?ready/failed是终态,尤其failed——用户可能已经决定不重试,worker 不该替他翻案。 - 还有未完成的
ingest/embed_visual吗?有就还没到终态。thumbnail/pdf_preview不挡:预览没生成不影响”内容能不能搜”。 - 该有的页级点齐了吗?
scan_pages非空时,kb_visual的点数必须 ≥ 页数;不够且没有待办任务,就是failed。
纯扫描件/照片在 ingest 结束时是 pending,等所有页级视觉任务到终态再翻。全失败时没有任何 handler 会跑到收尾,所以判定必须挂在”每个任务到终态”这个时刻,而不是某个 handler 的末尾。
scan_pages 为 NULL 是”加这一列之前摄取的,页码无从得知”,对账要跳过;但任务表仍然知道哪些页本该被编码。如果视觉任务已全部终态失败,这是确定的问题,判 failed,让用户拿到”重解析”入口。
启动时 sweep_stuck_docs 补扫”中间态却没有任何待办任务”的文档。正常情况下这里什么都没有;它存在是因为 worker 可能在 finish_job 提交之后、文档结算提交之前被杀,那个窗口只有几毫秒,但一旦发生就是永久卡住。
巡检
uv run python deploy/monitor.py            # 人看
uv run python deploy/monitor.py --json     # cron / CI
uv run python deploy/monitor.py --quiet    # 只在有问题时输出
12 个检查函数,报告通常 14 项(Qdrant 函数 add 两条,另加备份)。退出码 0 正常 / 1 有问题。
| 检查 | 抓什么 |
|---|---|
| Postgres 可连 | 库挂了全站 500 |
| Qdrant 活着 / 可列集合 | 索引服务挂了检索降级、摄取全失败 |
| API 健康 | 进程活着但依赖坏了 |
| BM25 df 一致 | corpus_stats.n_docs vs chunks 行数;不是报错,是检索质量悄悄变差 |
| Embedding 模型一致 | 建索引模型 vs 当前配置;不一致时 dense 腿静默错排序 |
| 索引对账(dense/sparse) | 分腿漂移 |
| 视觉腿对账 | kb_visual 的页级点 vs scan_pages |
| 没有卡住的文档 | 中间态却无待办任务 |
| 磁盘占用 | 写满会让摄取静默失败(上传仍 202) |
| 没有卡住的任务 | running 超过 30 分钟 |
| 失败任务积压(近 24h) | 有没有需要人看的失败 |
| 队列滞后 | 最老 pending 等了多久,阈值 30 分钟 |
| 最近有备份(≤3 天) | 太旧等于没有备份 |
跳过不算健康。巡检没配好 API Key、VDR_ENABLED=false、索引模型还没有记录,这些是”这项没验”,既不是通过也不是失败。第一版只判 failed/warned,于是两项鉴权检查被跳过时报告仍写”一切正常”、退出码 0——这是监控工具最坏的失败:它让人放心。
索引对账不走 API。巡检账号无法加入别人的工作区,走 /admin/consistency 只能看到自己的库;巡检回答的是”索引和库对不对得上”,不是”某个用户能看到什么”。判据直接来自 common/consistency.py,与 API 端点、worker 的定期对账共用同一份。
定期任务
worker 空闲时做两件旁路工作:
- 索引对账:首次延迟 180 秒,之后每 900 秒一次。只报告、不修。忙的时候不查——那时漂移多半正在被正常摄取/清理修掉。
- 非当前点清理:首次 120 秒,之后每 300 秒一次,删已提交为非当前的文档的三腿点。它和对账方向相反:对账怕删正在写的点,这里删的是永远不会再被检索的整份点集,不产生空洞。
两者失败都不打断任务循环。
备份与恢复
bash deploy/backup.sh
bash deploy/restore.sh --scratch data/backups/<时间戳>
备份内容:
- Postgres:
pg_dump -Fc,拷出容器而不是用管道重定向(管道中途断了会得到大小正常但截断的 dump,恢复时才炸)。 data/blobs/:tar 包里路径是blobs/...,恢复时tar -C data_dir能落回原位;另存逐文件 sha256 清单。- Qdrant:不备份。manifest 里记三个 collection 的期望点数,重建后按它对账。
- manifest:逐表行数 + 各文件 sha256。
备份完立刻自检。restore.sh --scratch 恢复到临时库,逐表行数对账、逐个 sha256 校验,然后删临时库。这是唯一能证明”备份能用”的方式;只跑 backup 看它”成功”证明不了恢复。生产恢复要 --force --into,并且先停 API/worker。
恢复后必须重建索引:POST /admin/reindex。重建后的点数与 manifest 的 qdrant_expect 对账,超出 5% 要查原因。
重建与蓝绿
POST /admin/reindex?kb_id= 入队重建,不阻塞 API。默认范围是”我有权访问的库”,不是全库;越权的全库重建等于让别人库在重建期间搜不到。
swap=true 是整实例蓝绿重建,需要超管与别名模式:
uv run python deploy/bootstrap_index_aliases.py --yes   # 一次性迁移
# .env 设 QDRANT_ALIASES=true,重启 API/worker
curl -X POST -H "Authorization: Bearer $KEY" \
  'http://127.0.0.1:8010/api/v1/admin/reindex?swap=true'
建影子 → 灌数据 → 验点数 → 原子切别名 → 旧集合保留回滚。默认不开:逻辑名就是真实集合,行为与以往完全一致。别名不出现在 GET /collections,巡检里列的是物理集合名,正常。
日志与排障入口
三个进程三个日志:
tail -20 /tmp/pkh_api.log /tmp/pkh_worker.log /tmp/pkh_visual.log
curl -s --noproxy '*' http://127.0.0.1:8010/health
dev.sh 只有 start / restart / stop,没有 status / logs;状态用 /health 与日志看。视觉服务可以单独 bash deploy/visual.sh status|logs。
队列状态在鉴权版 /api/v1/health 的 queue 段:pending、running、failed_24h、oldest_running_seconds、stuck_after_seconds。它不是心跳——worker 是独立进程,空闲时不写库;队列状态回答的是”堆了多深、最老的跑了多久”。
扩容
- 多 worker:
PKH_WORKERS=N。先开VISUAL_WRITE_VIA_SERVICE=true,让写侧也走 8020;否则每个 worker 各占 2.65GB。代价是摄取依赖视觉服务:它挂了,照片/扫描件任务会失败并重试。 - 连接池:API 默认 5+5;一次 hybrid 检索最多占 4 条连接,按并发检索数 × 4 估。池不够时请求排队,延迟变差但不会算错。
- 视觉查询并发:服务端上限 4,客户端也限 4。实测 6 路并发吃 8.7 个核、单条 p95 905ms;2 秒预算包含排队,排不到就降级。
- 磁盘:blob 与数据库同分区;写满时上传仍返回 202,摄取静默失败。巡检的磁盘项是少数能提前发现它的地方。