knowledge-hub
对外接口
同一个知识库,浏览器要 HTTP、AI 客户端要 MCP、别的 Agent 要 A2A。三种传输的字段形状不同,但”怎么检索、怎么回答、怎么判权限”必须只有一份实现。否则半年后会出现”网页搜得到、MCP 搜不到”这种两边都不报错的差异。
三个入口,一个内核
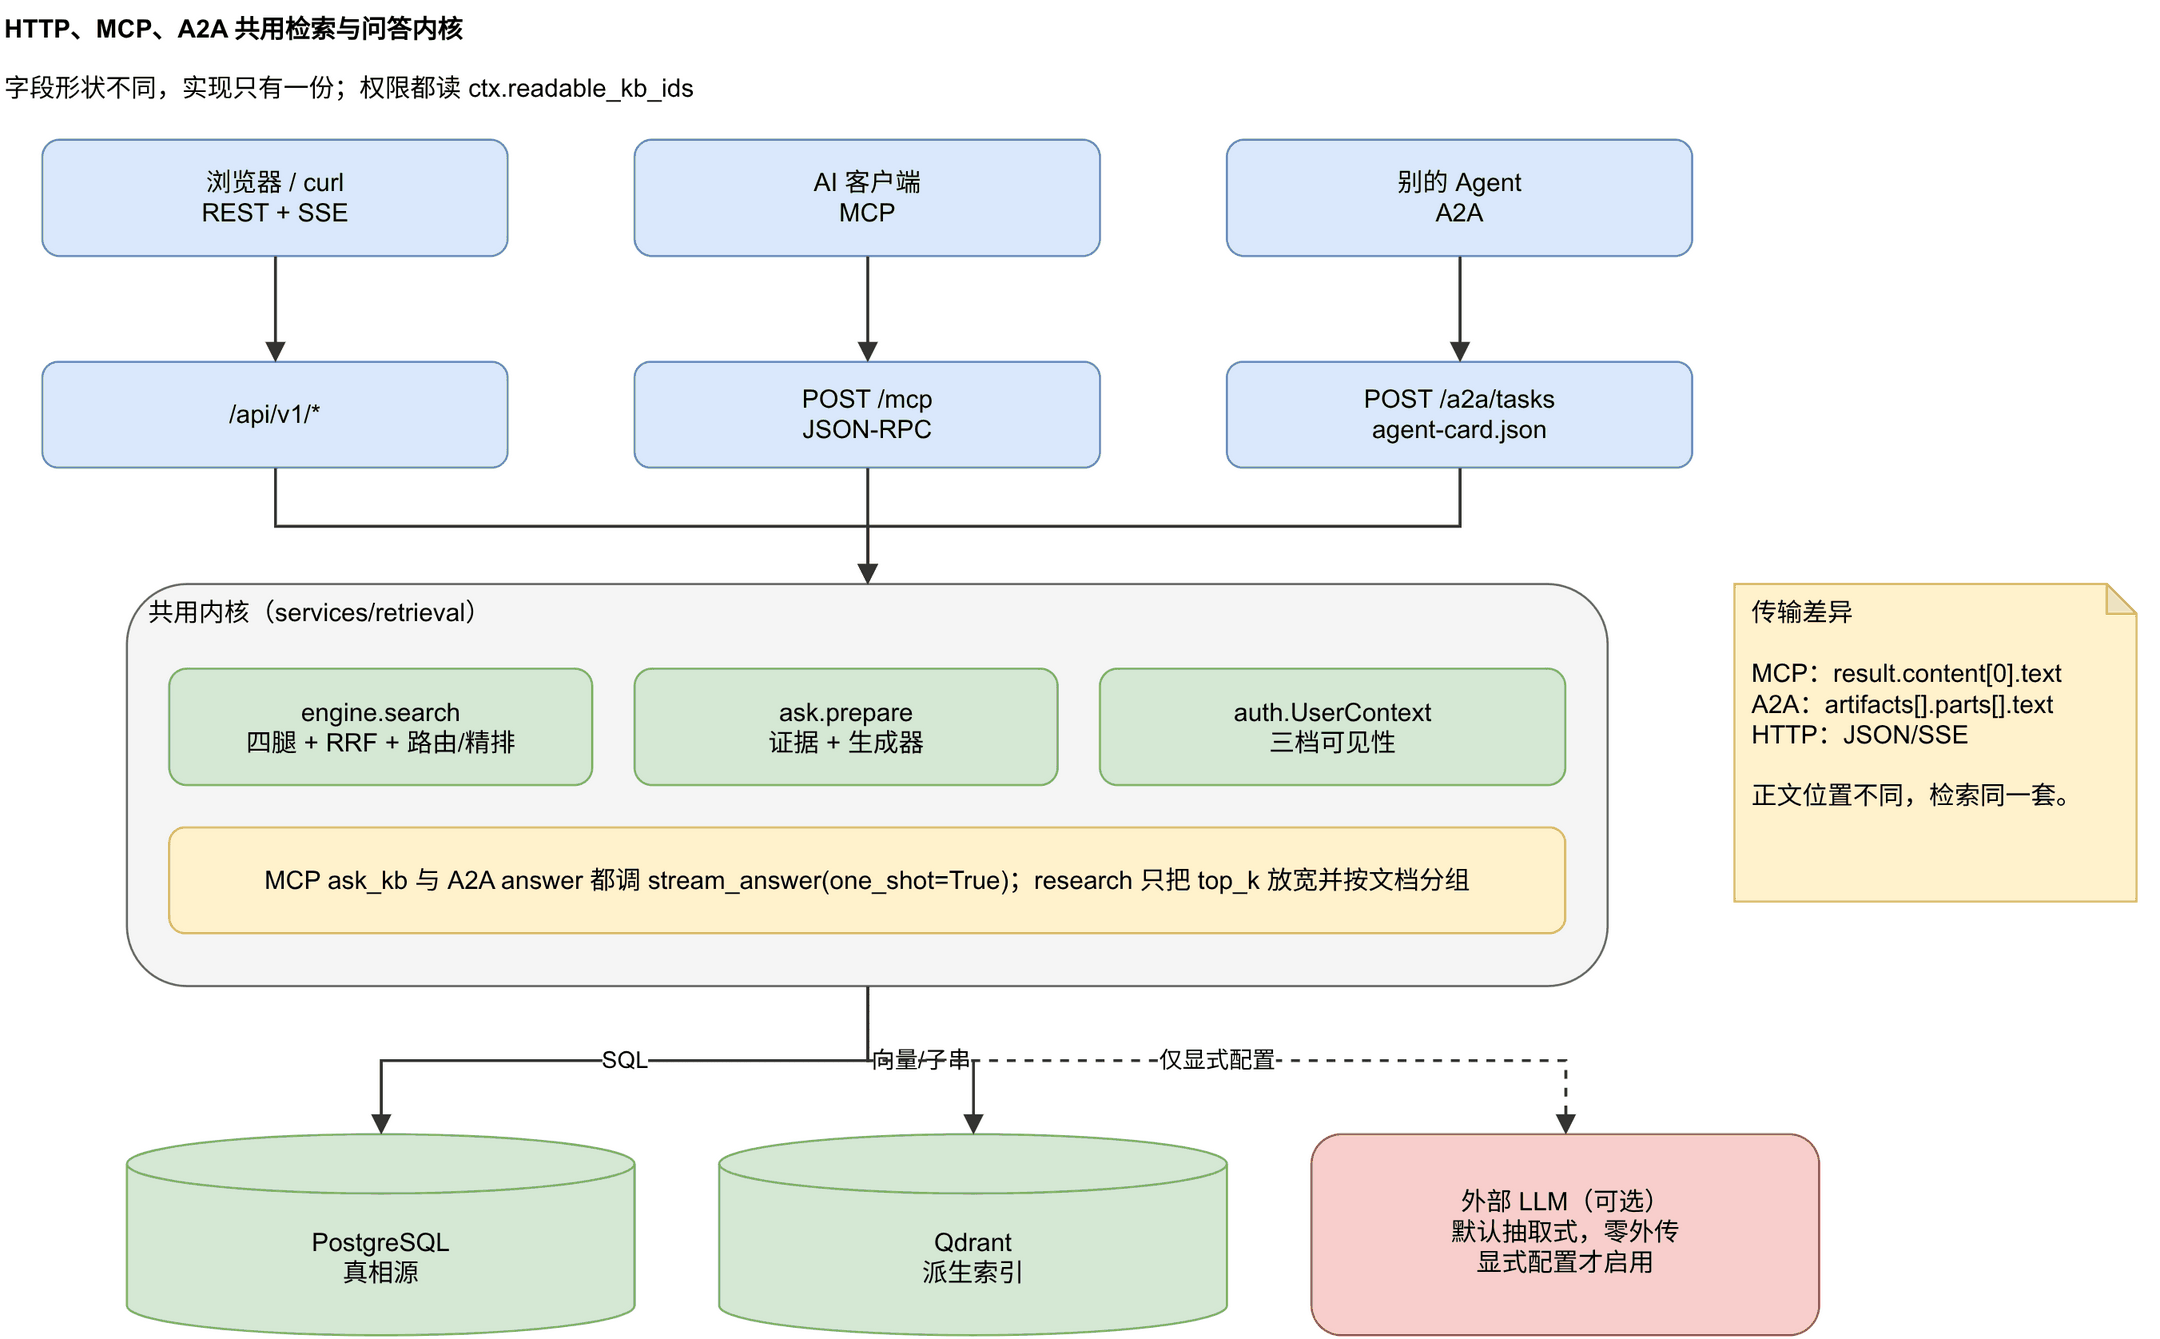
| 入口 | 传输 | 能力 | 内核 |
|---|---|---|---|
| HTTP | REST + SSE | 82 个契约端点,81 实现,1 个明确不做 | engine.search / ask.prepare + stream_answer |
| MCP | POST /mcp,Streamable HTTP,无状态 |
4 个工具 | 同上 |
| A2A | GET /.well-known/agent-card.json、POST /a2a/tasks |
answer、research |
同一 ask 内核 |
MCP 与 A2A 都挂在根路径,不在 /api/v1 下:MCP 客户端按固定路径找 /mcp,A2A 的 Agent Card 是规范里写死的发现路径。
鉴权复用同一套 Bearer API Key。三个入口都从 ctx.readable_kb_ids 取范围,不各自重算可见性。
HTTP
基址 http://127.0.0.1:8010/api/v1,除 /health 与 /auth/* 外都要 Bearer Token。契约在API 契约,这里只讲形状上容易踩的地方。
错误响应统一是:
{"error": {"code": "KB_NOT_FOUND", "message": "资源不存在或无访问权限",
           "detail": {"kb_id": 999}, "request_id": "req_..."}}
权限不足与不存在同码。FORBIDDEN 只用于操作级拒绝(如非超管调 /admin/users)。
分页不统一:一部分端点返回 {items,total,page,page_size},一部分返回裸数组;裸数组也接受 page/page_size,只是丢掉 total。新端点一律用分页包,把历史端点改成包属于破坏性变更。
SSE 固定在 POST /ask 与 POST /kb/{id}/ask。帧序 sources → delta* → done;stream=false 仍返回 SSE,只是一个 delta。响应头带 X-Accel-Buffering: no,避免 nginx 把增量攒到结束才吐。
检索三个端点:单库、跨库、单库调试。mode 只控制文本三腿;视觉腿由服务可用性决定。include_debug=true 与 /search/debug 共用同一个 _debug_block,形状一致。
文件预览:GET /documents/{id}/preview 不带参数时返回预览文件本身(PDF 原件、图片原件、Office 转换版),带 page 时返回页图,带 chunk_index 时把坐标框画进页图。Office 返回的是转换版本,响应头 X-Preview-Source: converted 如实标注。
MCP
initialize / notifications/initialized / ping / tools/list / tools/call。未知方法回 -32601。
四个工具:
| 工具 | 参数 | 说明 |
|---|---|---|
list_kb |
— | 列出调用者有权限的 KB |
search_kb |
kb_id、query、top_k、mode |
三路 RRF 检索 |
ask_kb |
kb_id、question、top_k、session_id |
RAG 问答(非流式) |
get_document |
kb_id、doc_id、limit |
文档元信息 + 前 N 个 chunk |
传输层三个决定:
- 无状态:不实现
Mcp-Session-Id。鉴权是每请求自带的 Bearer Key,没有会话状态要维护,也就不用处理会话过期/泄漏。 - 响应是
application/json:单条请求直接回 JSON,不必包成 SSE 帧。协议错误也回 HTTP 200(错误在 body 的error里),只有”根本不是 JSON-RPC”才回 400。客户端库会把 HTTP 4xx 当传输故障,那样就拿不到error.code。 - 权限裁剪两处:
tools/list的kb_idschema 用 enum 只列有权限的库;tools/call仍然走assert_kb_access。只靠第一处的话,改一次客户端入参就能越权。一个库都没有时不暴露三个带kb_id的工具,而不是给一个空 enum 让调用方每次都失败。
错误分两层:
| 情况 | 落点 |
|---|---|
| 未知方法/未知工具 | JSON-RPC -32601 |
| 参数不合法(缺必填、类型错、越界、未知参数、enum 不符) | JSON-RPC -32602,message 形如 search_kb: 缺少必填参数 kb_id |
| 库不存在 / 无权限 | result.isError=true + {"error":"KB_NOT_FOUND"} |
| 其它未预期异常 | -32603 |
参数错是协议错,业务失败是结果失败。混在一起,模型会把”我少传一个参数”误读成”这个库不存在”,于是换一个不存在的 kb_id 反复试。
top_k 越界在 MCP 侧报错而不是夹取:schema 已经告诉调用方上限,悄悄改成 50 会让”我要 80 条”变成”我拿到 50 条”而无人察觉。HTTP 侧仍是夹取,因为那里是给人调用的。
工具结果一律是 JSON 字符串塞进 content[0].text。MCP 客户端必须支持 text 内容类型;自造类型会被当”未知类型”丢掉,表现为”调用成功但没有内容”。
A2A
两个 skill:
| skill | 用途 | 实现 |
|---|---|---|
answer |
单轮查资料,答案带 [n] 引用 |
ask.prepare + stream_answer(one_shot=True) |
research |
多角度检索,按文档分组给摘录 | 同一内核,top_k 放宽到 30,按文档分组 |
research 不是“让 LLM 规划多轮检索”。默认生成层是抽取式,本机没有 LLM,内容是私人数据。它做的是可解释的多角度汇总:把命中按文档分组,每份文档给出最相关的句子摘录与出处,调用方自己综合。返回里带 extractive: true,不假装有多轮规划能力。
POST /a2a/tasks 收两种入参,都走同一个内部函数:
// 协议面
{"jsonrpc":"2.0","id":1,"method":"tasks/send",
 "params":{"skill":"answer","kb_id":88,
           "message":{"parts":[{"kind":"text","text":"…"}]}}}
// 便捷面(curl / 手测)
{"skill":"answer","kb_id":88,"query":"…"}
响应是 A2A Task 对象:{id, contextId, status:{state:"completed"}, history:[…], artifacts:[{parts:[…]}], metadata:{kb_id, skill, sources, documents}}。
读响应先看 Agent Card:
- 正文在
artifacts[0].parts[0].text,没有顶层answer; - 引用来源在顶层
metadata.sources,idx与正文[n]对应; - 引用角标在
artifacts[0].parts[0].metadata.citations; metadata.documents是 research 的按文档明细,truncated说明是否被上限截断。
kb_id 必填,Agent Card 刻意不列出可用值——那是权限信息。capabilities.streaming=false 是如实声明,端点确实非流式。无权限与不存在同码 403。
Agent Card 的 inputSchema/outputSchema 必须与真实响应对应。tests/test_a2a_skill_schemas.py 会拿真实调用逐字段核对;否则它就是第二份契约,迟早漂。
三方共用的边界
- 检索实现唯一:
services/retrieval/。任何一方想自己拼 Qdrant 查询或 SQL 子串查询,就是架构性错误。 - 问答实现唯一:MCP 的
ask_kb和 A2A 的answer都调stream_answer(one_shot=True),把 SSE 帧解析回结构化结果。少一条响应格式,就少一条会漂的路径。 - 权限实现唯一:两边都读
ctx.readable_kb_ids,都走assert_kb_access。不重算三档可见性。 - 审计:
tools/call记mcp_call,A2A 每个任务记a2a_call,HTTP 检索/问答记search/ask。审计在开流之前提交,避免检索失败时跟着回滚。
什么不做
- MCP 不做 resources / prompts / logging。声明了客户端会尝试用,而那些必然失败。
- A2A 不做流式、不做 push notification。能力声明反映实际实现,不声明做不到的事。
- 不提供
/jobs/{id}/retry。重试入口是文档级POST /documents/{id}/retry,给 job 再开一条重试路径等于同一次摄取有两个入口,去重语义只能覆盖其中一个。 - 不在 Agent Card 或
tools/list里泄露”存在但无权”的库。