knowledge-hub
数据与一致性
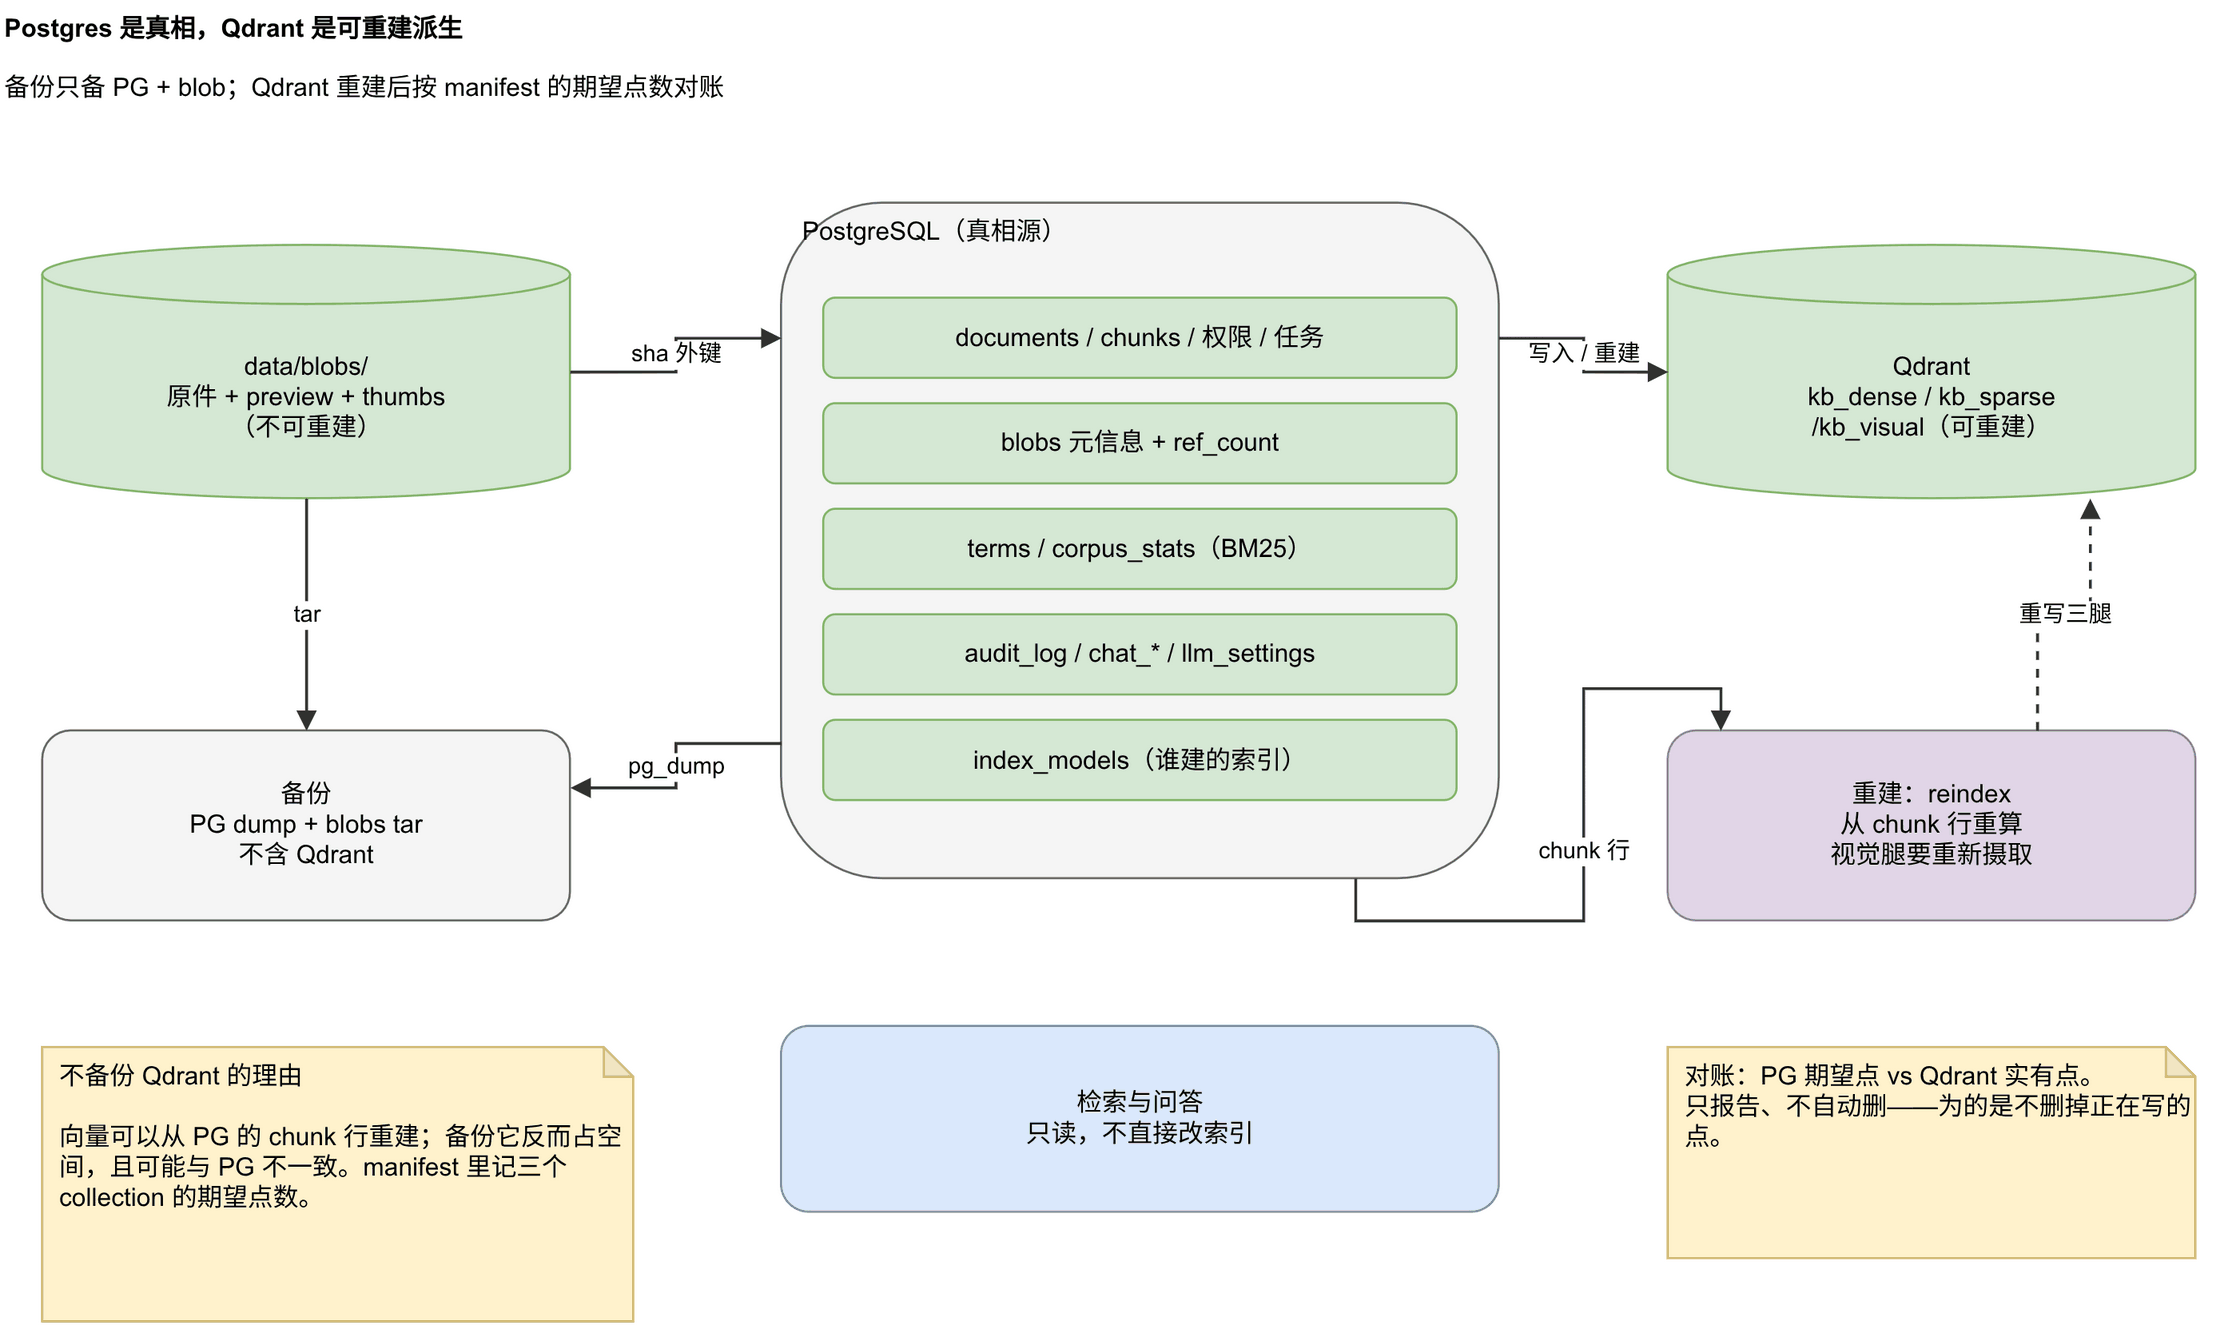
这个系统把”事实”和”由事实算出来的东西”分开得很硬。Postgres 里的行是事实;Qdrant 里的点、BM25 的统计量、缩略图、Office 预览都是可以重算的派生数据。分清这一点,删除、对账、重建才有唯一答案:派生数据坏了可以重建,事实坏了只能备份恢复。
18 张表怎么分层
初始迁移建了 11 张表,之后 22 个迁移加到 18 张。按职责分四层:
| 层 | 表 | 作用 |
|---|---|---|
| 身份与容器 | users、workspaces、workspace_members、workspace_invites |
账号、工作区、成员、邀请码 |
| 内容 | knowledge_bases、documents、blobs、chunks |
知识库、文档版本、原始文件、块 |
| 任务与审计 | jobs、audit_log |
异步任务、操作留痕 |
| 检索与对话 | terms、corpus_stats、index_models、chat_sessions、chat_messages、chat_day_stats、llm_settings |
BM25 词表、建索引模型、会话消息、聊天聚合、外部 LLM 配置 |
所有时间列都是 TIMESTAMPTZ;软删除统一用 deleted_at,查询默认带 deleted_at IS NULL。扩展 pg_trgm 由迁移创建,不在 ORM 里声明;pgvector 镜像装了但不用——向量归 Qdrant,因为 colSmol 的 late-interaction 不是 pgvector 的形状。
迁移里有一类不能靠 autogenerate:CHECK 约束的取值变更(新增 chunk_strategy、改 jobs.kind、加 users.role)。autogenerate 只比对外键/索引/列,不检测约束表达式,所以这些迁移都是手写的。改约束后要跑 alembic check,否则会出现”模型里有、库里没有”的漂移。
原始文件:内容寻址
文件按 sha256 存在:
data/blobs/{sha[:2]}/{sha}/original
data/blobs/{sha[:2]}/{sha}/preview.pdf
data/blobs/{sha[:2]}/{sha}/thumbs/{page}.jpg
按前两位分 256 个子目录,避免单目录几十万文件让 ext4 目录项退化。同一份内容被多个文档版本引用时只存一份,blobs.ref_count 记引用数;减到 0 才物理删目录。
documents.blob_sha 外键指向 blobs.sha256。漏登记 blobs 行会直接撞外键,而不是”文件写不进去”;这个错误只在真正写入时出现,所以上传与导入两条路径共用一份 _create_doc,避免一边记得、一边忘了。
storage_path 这一列只是写入时记下的路径,没有任何代码读它做分发。现在没有对象存储抽象;要上第二台机器或让备份出本机时,才需要先做只读远端副本,不动在线读写路径。
chunk:检索的最小单位
chunks 一行是一个块,关键字段:
| 字段 | 用途 |
|---|---|
content_norm |
归一化文本,嵌入与 trgm 用 |
char_start / char_end |
在全文里的字符偏移(部分格式有) |
locations |
L3 坐标数组,[{page, bbox}],已归一化 0~1 |
kind |
text / table / page / chat |
table_json |
表格的结构化网格,前端渲染真表格用 |
parent_text |
Parent-Child 的父块上下文,不进向量库 |
section_path |
H1 > H2 > H3,章节路径 |
token_count |
估算 token 数,用于统计与上限判断 |
content_norm 是 Markdown 或清洗后的正文;表格块额外带一句规则生成的描述(”N 行 × M 列;表头:…”),让”一览表”类查询能召回表格。locations 里正文块通常一个框,表格块每个非空单元格一个框并带 row/col,扫描页只有整页。
判断”有没有坐标”必须看内容,不能看 locations IS NULL:这一列是 JSONB,空列表常常存成 JSON null 而不是 SQL NULL,用 SQL 判会一条都筛不出来。has_locations() 逐项检查有没有 bbox。
软删除、版本与恢复
documents 用两个字段表达”哪一版活着”:
is_current=true的版本参与检索;deleted_at非空表示进了回收站,30 天后物理清理;version_id是同一(kb_id, file_name)的第几版。
覆盖式更新时旧版本 is_current=false 且 deleted_at 置为当前时间,新版本 version_id +1。回收站恢复时不会复用旧向量,一律重新入队摄取;因为期间可能改过切分参数,旧块已经过时。
knowledge_bases 与 workspaces 也是软删除。删工作区不级联软删其下的 KB/文档,只标记工作区一行;恢复也只翻一行。代价是”删掉工作区”必须真的让它不可见:可见性判定里有一个 EXISTS(工作区未软删),且它必须与三档可见性条件放在同一个 AND 里。写成第四条 OR 分支等于没限定——这是真实越权过的形状。
删库会把它下面当前版本的文档一起标软删,共享同一个 deleted_at 时间戳;恢复时按这个时间戳精确匹配,只恢复”那次删除带走的”文档,不把更早单独删掉的、或被同名版本顶替的也带回来。
删除链
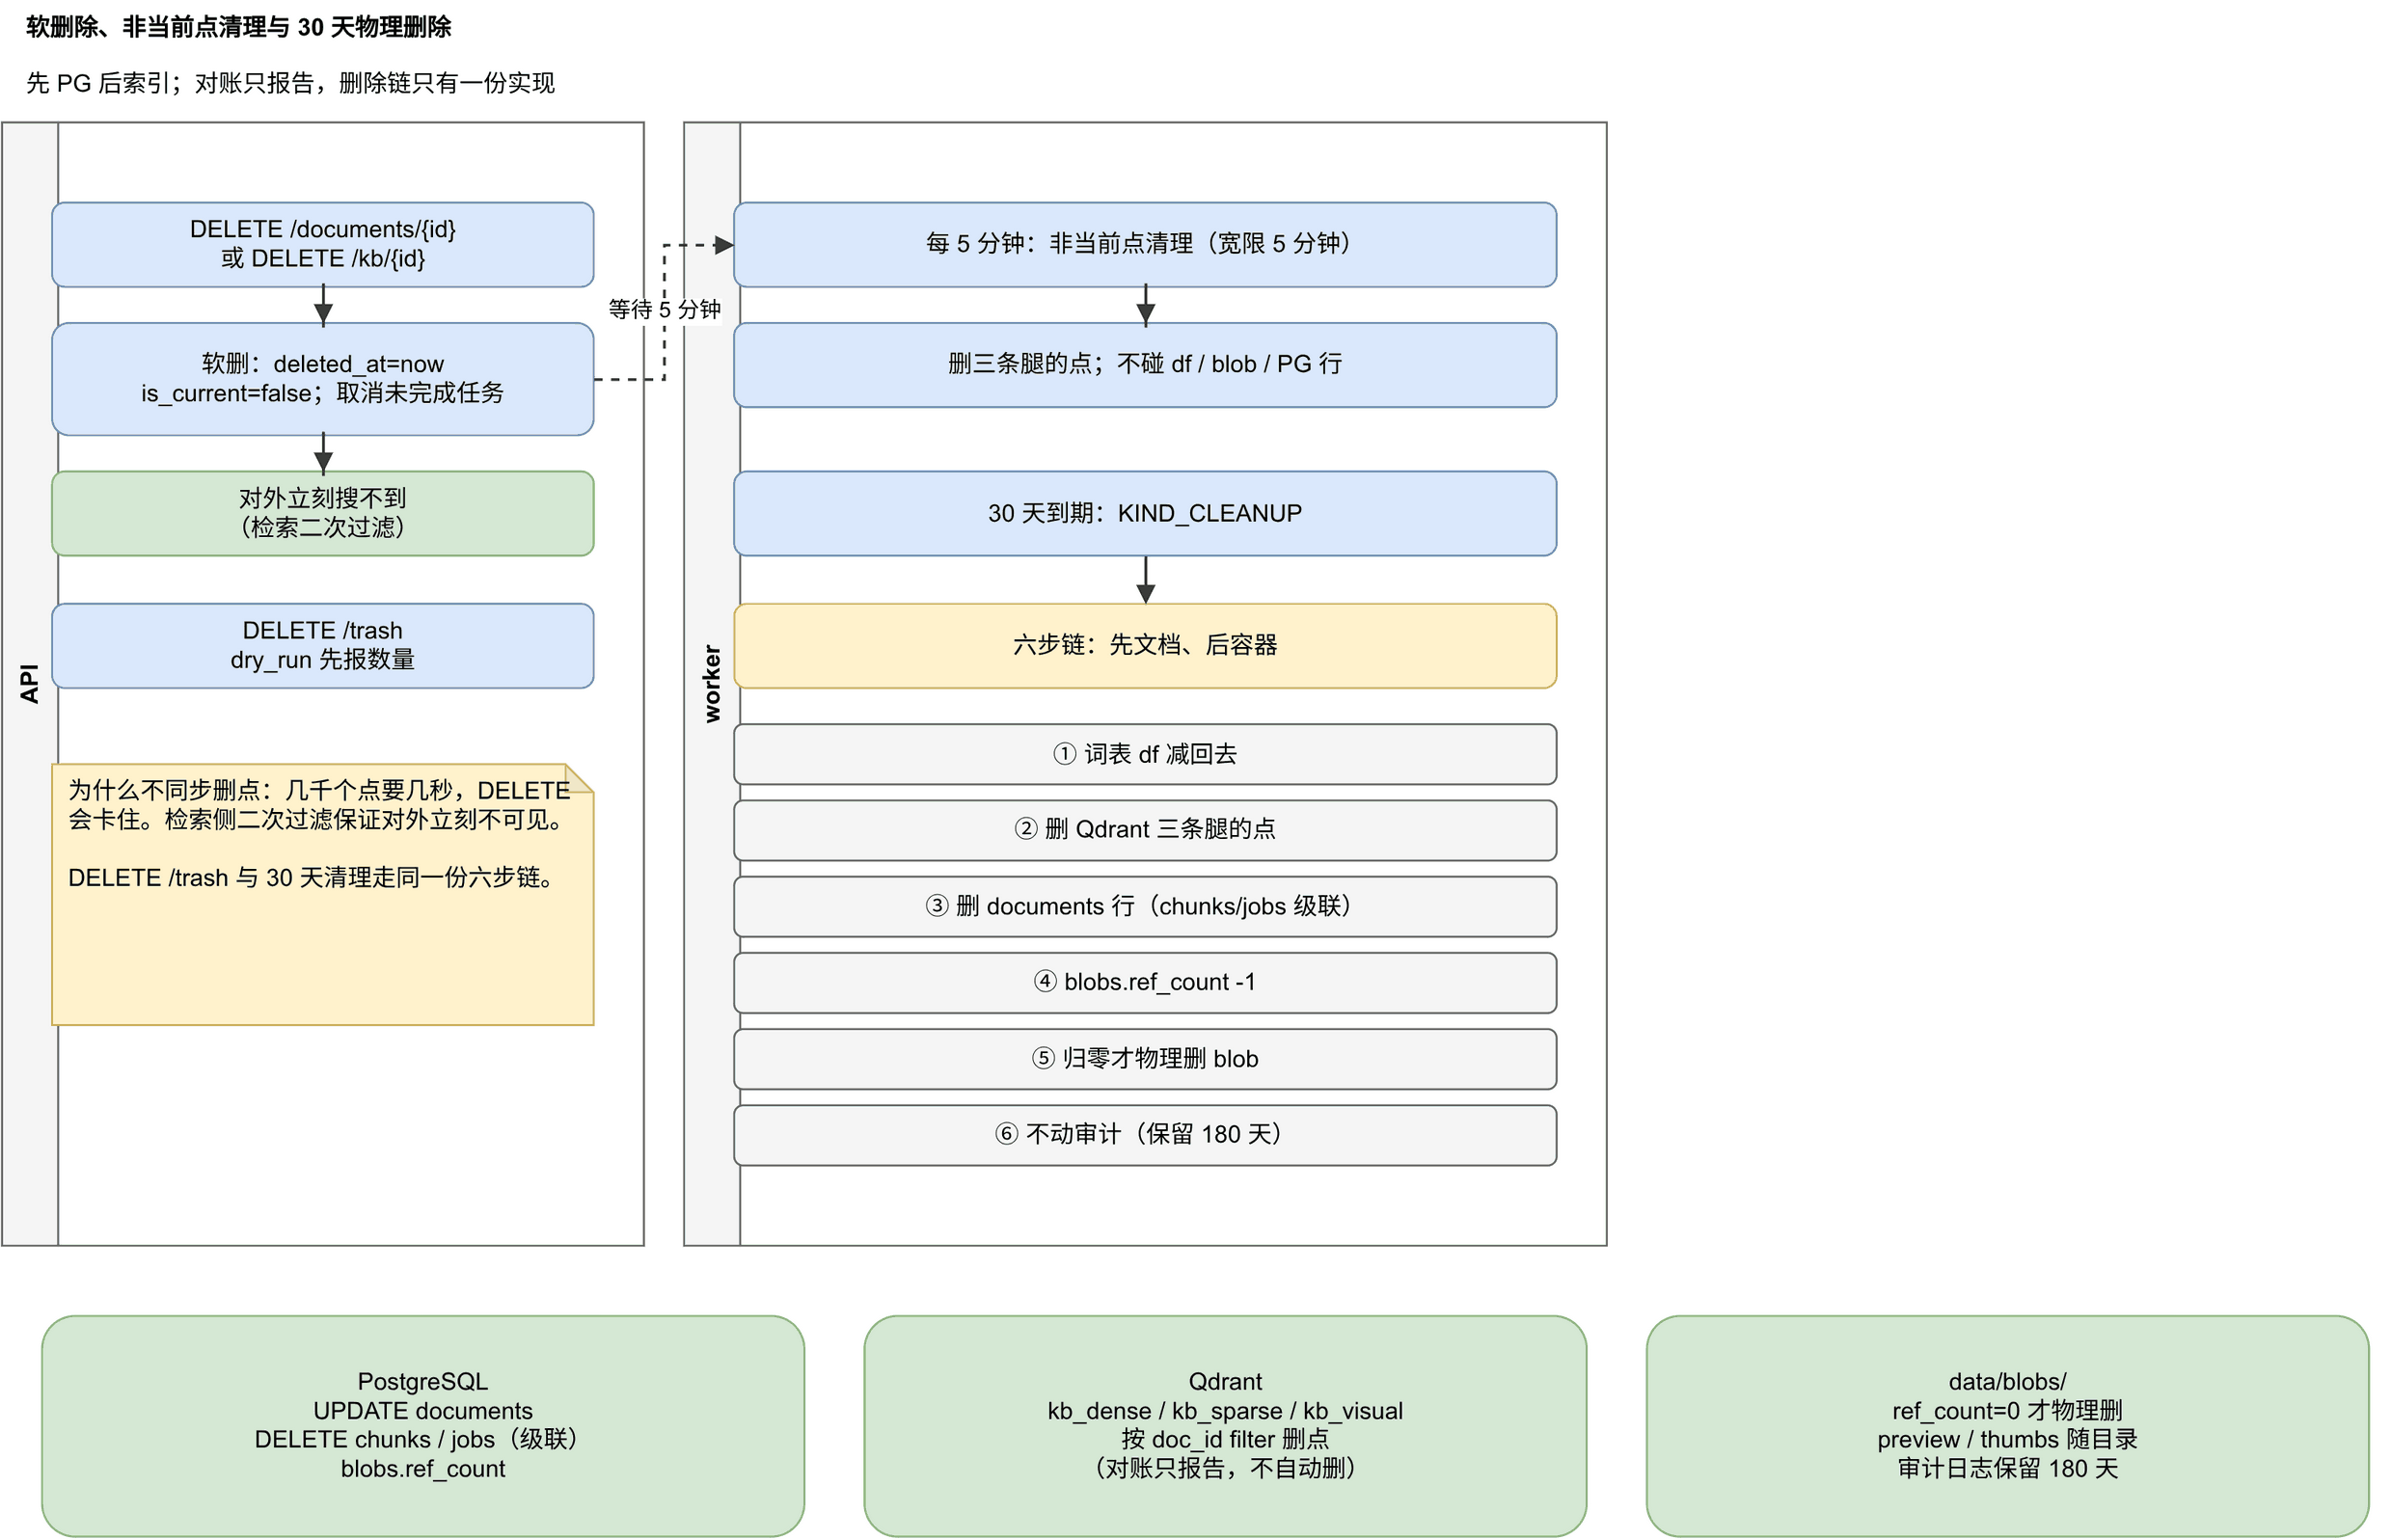
物理删除有六步,顺序不能换,每一步漏掉都不报错:
- 把 chunk 的 token 从 BM25 词表里减回去(
df只加不减会虚高,idf 被压平,检索质量悄悄变差)。 - 删 Qdrant 三个 collection 里属于该文档的点。
- 删
documents行(chunks/jobs靠ON DELETE CASCADE跟着走)。 blobs.ref_count-1。- 归零才物理删 blob 目录。
- 不动审计日志:审计保留 180 天,”人走了记录还在”。
这条链只有一份实现,worker 的 30 天到期清理与 DELETE /trash 手工清空共用。同步/异步各一份驱动,但选择条件与 df 算法共用同一份构造器,避免两边漂。
删除文档时 API 只做软删并取消未完成任务,不同步删 Qdrant 点:几千个点要几秒,会让 DELETE 卡住。检索侧二次过滤 is_current,对外表现是立刻搜不到。
非当前点另有一条更快的清理:文档被顶替或软删后,宽限 5 分钟,worker 每 5 分钟扫一次,把已提交为非当前的文档在三条腿上的点删掉。它只删 Qdrant 点,不碰 df/blob/PG 行——df 的正确口径是”全部 chunk 行”,行要留到 30 天物理删除。恢复一律重摄取,所以旧点没有消费者,删了不会产生空洞。
任务、审计、词表
jobs 是 Postgres 任务表,不引入 Redis。任务与业务数据同库,外键级联能自动清掉文档的待处理任务;规模是 5~20 人团队,峰值几百条,PG 够用。轮询热路径有一张只索引 pending 的部分索引。
audit_log 存审计三元组 api_key_id → user_id → kb_ids 加 query 摘要、结果数、耗时。两个外键都是 SET NULL 而不是 CASCADE:审计的意义是主体消失后仍可追溯;跟着级联删会让删用户被外键挡住,或者把痕迹一起抹掉。
terms / corpus_stats 是 BM25 的增量词表与全局统计。词表是全局的(不分租户),因为稀疏向量的下标空间必须全局一致;副作用是一个罕见词在别的库出现过,这边的 idf 会被拉低——只泄漏统计量,不泄漏内容。修法是定期跑 reindex 重算。
index_models 记每条向量腿建索引时用的模型与维度。查询前 dense 腿会比对:不一致就 skipped,因为两个向量空间里算相似度不是”随机”,是整个排序基础坏了,而且不报错。没有记录时放行——未知不等于不一致,在未知上拦查询会把正常部署拦死。
对账与重建
对账分三条腿,不能取并集:kb_dense、kb_sparse 的期望点来自 chunks 行,kb_visual 的期望点来自 documents.scan_pages。取并集的话”只有一条腿坏了”会报成一致,而那正是真实故障模式。
-- 文本腿的期望集合(判据只有这一处)
SELECT kb_id, doc_id, chunk_index
FROM chunks JOIN documents ON documents.id = chunks.doc_id
WHERE kb_id IN (...) AND is_current AND deleted_at IS NULL
两侧都用同一个 point_id(kb_id, doc_id, chunk_index) 算键。自己另写一份公式,公式一改两侧一起错,对账会永远说一致。
对账只报告、不自动删。摄取时 chunk 行先 flush(不提交),点已经 upsert;在事务提交之前,另一个连接看到的”点存在、行不存在”其实是正在写的。自动删会把刚写进去的点删掉,随后行提交,留下永久索引空洞——比漂移更难修。
重建走 POST /admin/reindex,入队而不是同步跑:
- 词表先为全体 chunk 重新登记,再重建向量。
df与corpus_stats是全局量,只登记目标库会把别的库 idf 弄坏。 - 向量只重建目标库,按
kb_id排序、切到哪个库就先删哪个库的两条文本腿再重建。早期版本把所有目标库一起删光再建,百万 chunk 要几小时,期间所有库都搜不到。 - 视觉腿既不重建也不删。页级向量要重读原件 + colSmol 前向 15 秒/页,那是重新摄取,不是重建索引。删了建不回来,比漂移更糟。
- 孤儿点(Qdrant 有、PG 里连 kb_id 都没有)清理覆盖三条腿;它们永远不可能被重建,删掉零风险。
- 别名模式下
swap=true做蓝绿重建:建影子集合 → 灌数据 → 验证点数 → 原子切别名 → 保留旧集合回滚。
已知的一致性窗口
- 软删后 Qdrant 点还在,直到清理任务或非当前点扫描跑到;检索靠 PG 二次过滤挡住。
- 新字段(
table_json、updated_at)只对之后摄取的文档生效;旧文档带时间过滤时会被排除。 - BM25 的 idf 会随增量入库漂移,定期重建才能收敛。
- 备份只含 PG 与 blob。Qdrant 重建后的点数应与备份 manifest 里记录的期望点数对得上,超出 5% 要查原因。