knowledge-hub
问答
问答看起来是”检索完把结果丢给模型”,真正容易坏的地方在时序:什么时候检索、什么时候开流、流式期间能不能碰数据库、生成失败算不算这一轮失败。这个项目把这些问题都压到开流之前或流结束之后,中间的 SSE 只做一件事——把生成器的增量吐出去。
一次 SSE 的帧序
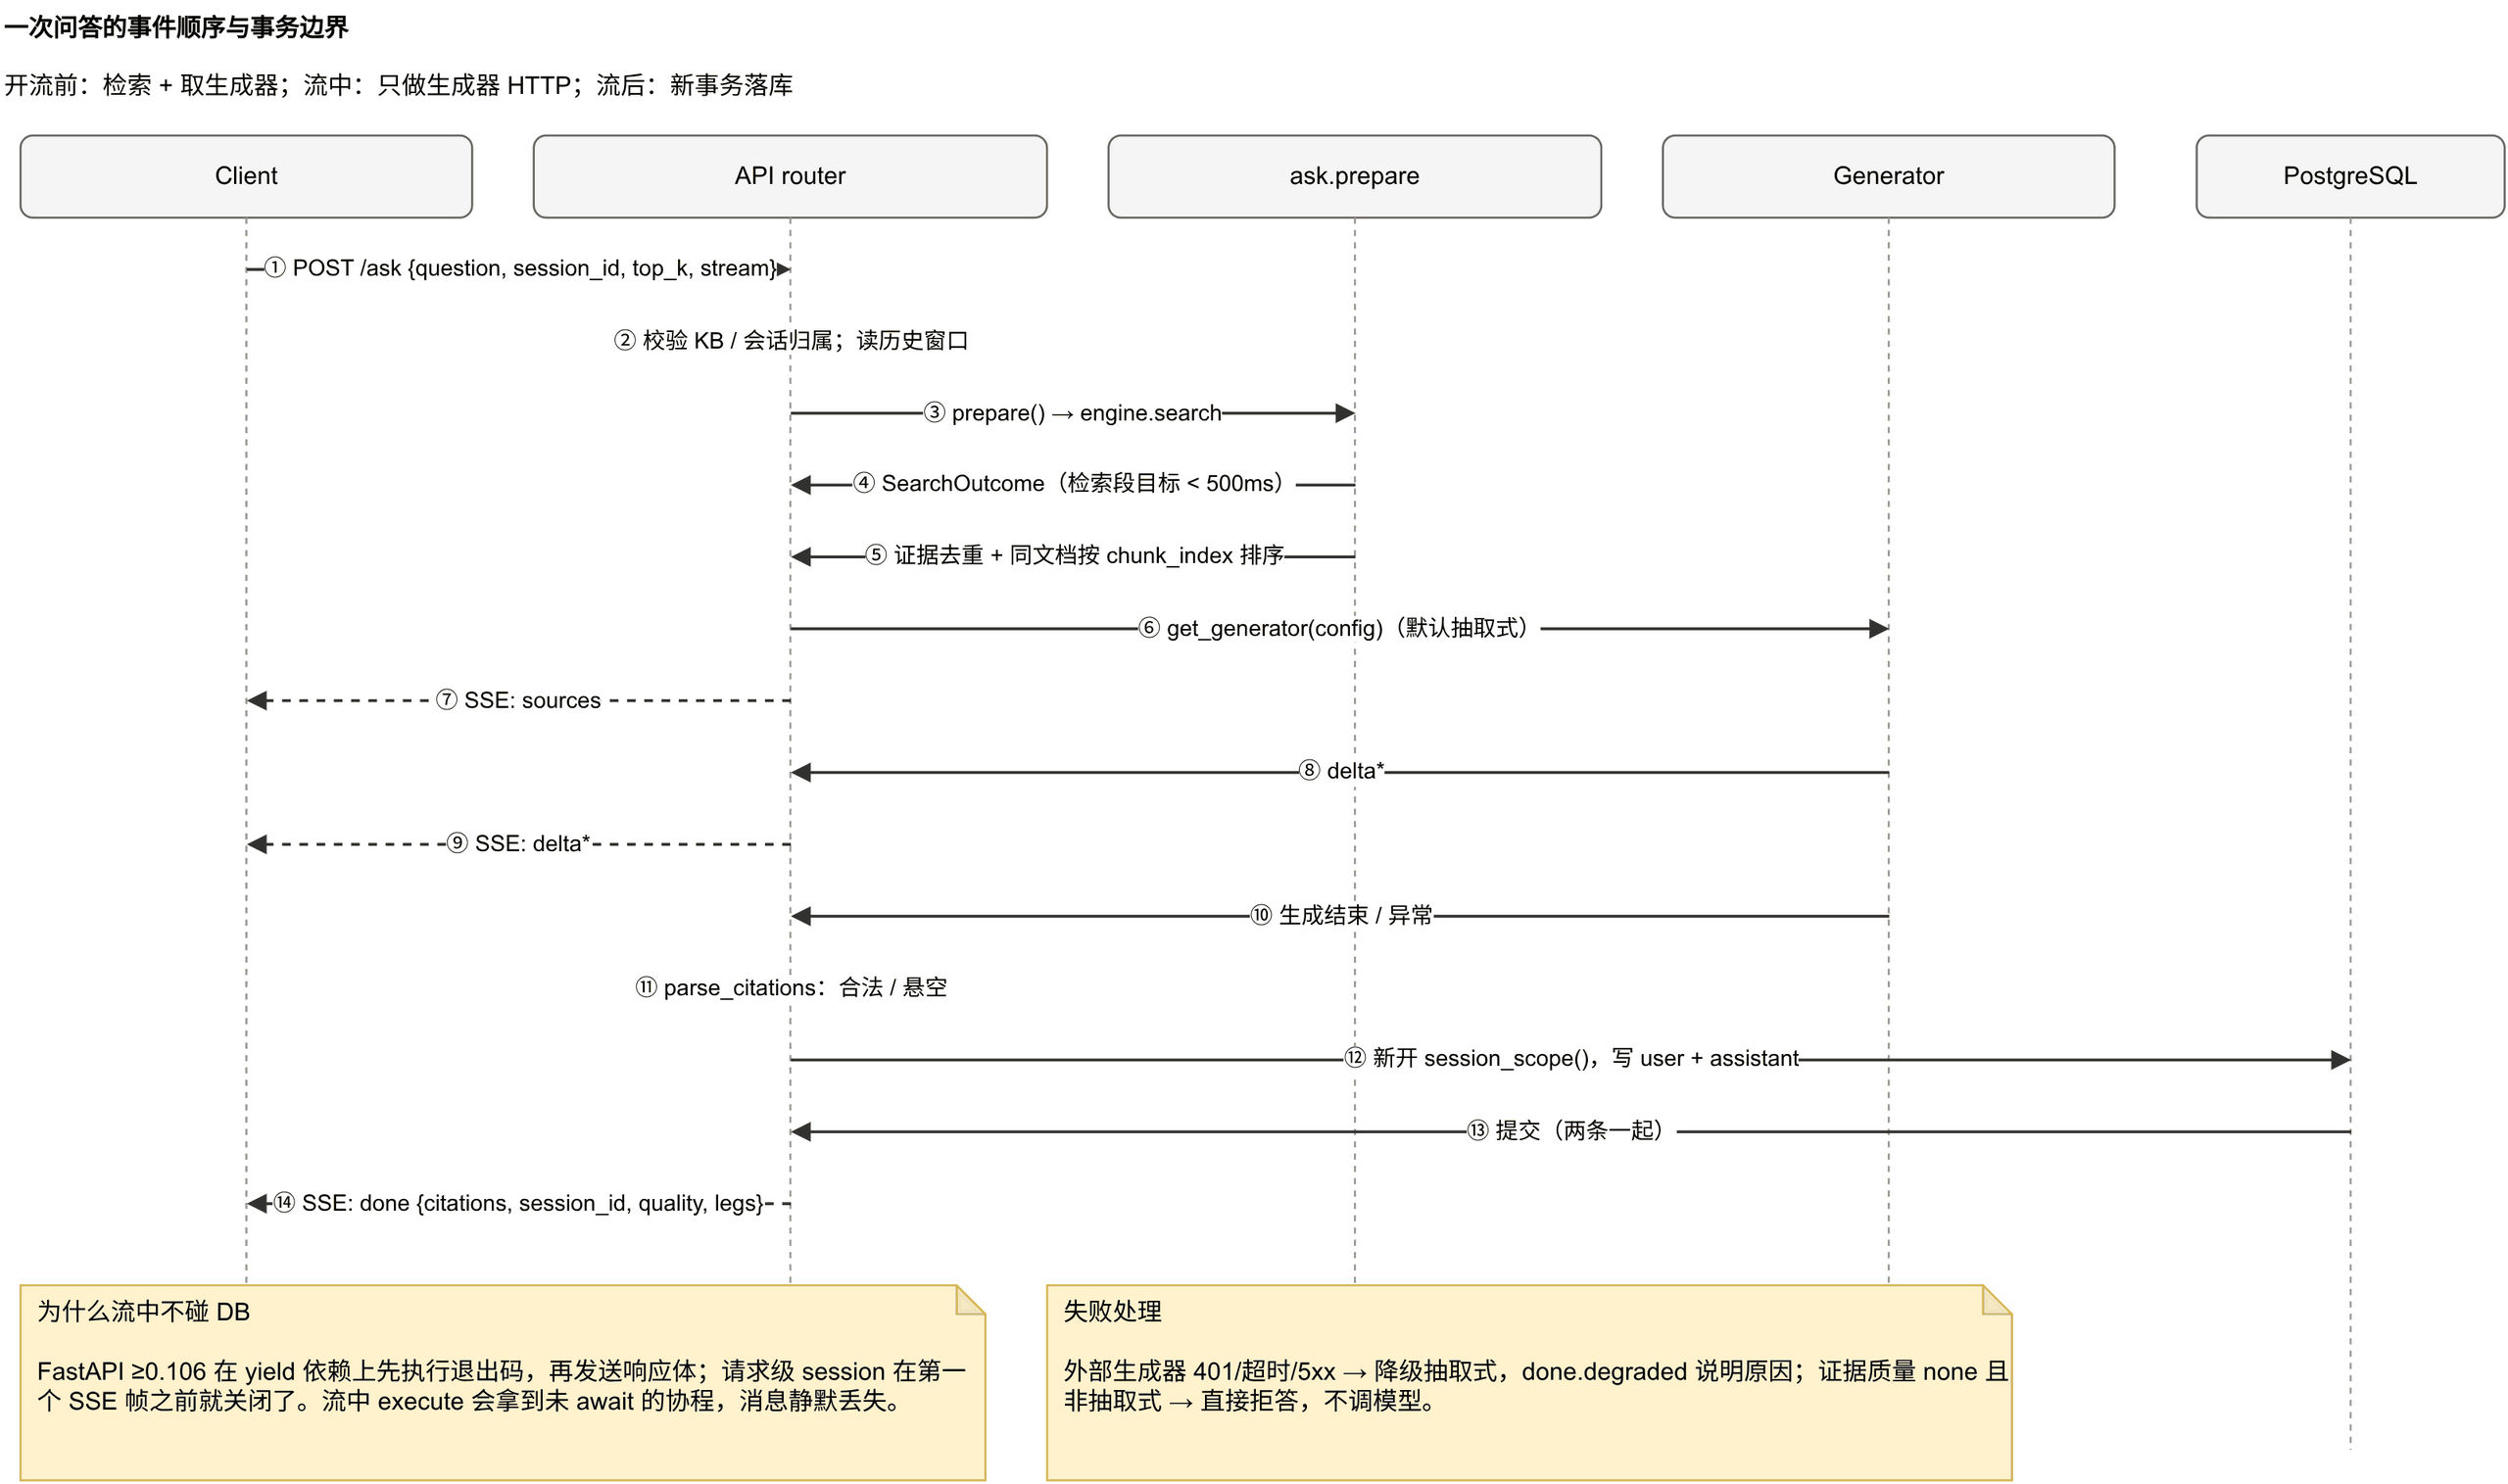
event: sources   ← 检索一结束就发,前端立刻能画引用卡片
event: delta     ← 一个或多个,逐字/逐句
event: done      ← 引用校验、会话 id、耗时、每腿状态、是否降级
sources 必须先于任何 delta。前端靠它区分”还在检索”与”在生成”;如果先来 delta,引用卡片就只能在答案出来之后补,首屏会空一段时间。
done 里的字段都不是装饰:
| 字段 | 用途 |
|---|---|
citations |
答案里合法角标,升序去重 |
dangling_citations |
引用了不存在的编号;应为空,非空时前端要提示”这条引用失效了” |
session_id |
新建会话时回传,前端靠它续问 |
history_turns |
这一轮带进生成的历史条数,第一轮是 0 |
quality |
ok / weak / none 与原因 |
degraded |
外部生成器失败并降级抽取式的原因;未降级为 null |
legs |
每条腿的命中数、耗时、跳过原因 |
stream=false 时仍然返回 SSE,只是所有增量合并成一个 delta。MCP 和 A2A 不在乎逐字输出,它们要的是完整答案;让三方共用同一条响应格式,比维护一条”非流式 JSON”分支更不容易漂。
开流之前
请求级数据库会话在第一个 SSE 帧之前就已经关闭——FastAPI 在 yield 依赖上先执行退出码,再开始发送响应体。所以检索、取生成器、组装证据都必须在这之前完成。
按顺序:
- 校验 KB 访问;带了
session_id就校验会话属于当前用户、属于当前 KB。 - 读历史窗口:默认最近 4 轮、总字符不超过 4000。按整轮丢弃,超预算就丢最旧的,不截断单条消息的中段。
- 指代式追问:问题短于 24 字、含”那栏/这个/刚才”这类指代词、且有历史时,把上一轮问句并进检索 query。检索发生在生成之前,只靠模型看历史救不了检索。
engine.search,top_k默认 8;单库时读该库的rerank_model,多库时不用精排。- 组装证据,取生成器。
审计也在这之前提交。SSE 一旦开始就改不了 HTTP 状态码,检索失败时审计不能跟着回滚——那正是最需要留痕的时候。
证据怎么排
检索结果先去重:同一条腿可能命中同一个 chunk,重复的证据会让 [1] 和 [2] 指向同一段文字,角标失去意义。
然后按文档分组,同一文档的相邻块按 chunk_index 升序,文档之间按首次出现的位置排。RRF 给的是相关性序,同一篇文档的相邻段可能被打散;按原文顺序放回,模型读到的才是连贯的一段,而不是跳着读。角标在重排后重新从 1 编号,否则会跳号。
只有当前版本的文档会进来:检索侧已经挡掉 is_current=false 和软删的行,所以”同一主题的多个版本混进上下文”在当前结构下不可能发生。这是结构保证,不是事后标注。
正文上限:普通证据取前 400 字,Parent-Child 库命中子块时改用父块,上限 1200 字。父块不进向量库,只随 payload 回传;召回靠小子块,生成上下文靠父段落。
抽取式怎么”生成”
默认生成器不调用任何模型。它做三件事:
- 切句。聊天文本常没有标点,先用
[昵称]标记切说话人,再按句末标点切;句子下限 4 字(聊天消息很短,设成 8 会把”你吃饭了吗”整条丢掉),上限 160 字。 - 给句子打分。用
bm25.tokenize切查询词,算覆盖率,超长句轻微降权。必须用同一个分词器,日期归一化 token(d20250214)才会一起进来。 - 选句。按分数降序,每条证据最多贡献 2 句,总共最多 6 句,避免一条长 chunk 把回答占满。输出按来源编号排序,形如
- 句子 [1]。
如果一句都选不出来,如实说”检索到的内容里没有能回答这个问题的证据”,不编。检索到图片但没有文字时,单独说”有图片内容,但没有可用于回答的文字证据”。
抽取式故意不用对话历史。它是”从证据里挑句子”,没有语言模型可以条件在对话上;真正让多轮起作用的是检索侧的指代扩展,那一条对两种生成器都有效。所以”抽取式 + 多轮”的效果是”追问能检索到”,不是”追问会接着聊”。
外部 LLM 与降级
生成层可插拔,但默认必须是抽取式。检索出的内容是聊天记录、简历、他人文档片段,发给外部 API 等于把私人数据送出本机。所以:
provider=openai_compat要同时配齐base_url、model、api_key,并且enabled=true;- 不满足时任一次调用都退回抽取式,
usable()会如实说差哪一项,不静默假装在用 LLM; - 细粒度开关
use_for_ask/use_for_contextual/use_for_rewrite分开控制哪些功能可以外传; - API Key 明文只进不出,读端点只回掩码。
外部生成器在流式过程中失败(401、超时、5xx)时:
- 还没有任何增量流出 → 用同一批证据干净地重跑一次抽取式;
- 已经流出部分文本 → 不再追加,避免两份答案拼在一起,但
done.degraded会说明这一轮降级了; - 抽取式自己也失败 → 不吞,抛出去,因为那是代码问题,不是配置问题。
证据质量为 none 且生成器不是抽取式时,直接拒答:”没有检索到可用于回答的证据。请换个说法,或用「精确搜索」直接找原文片段。” 不把空证据送给模型编。
引用校验
答案文本里的 [n] 用正则抽出来,合法的(1..证据数)进 citations,越界的进 dangling_citations。悬空角标必须为空;出现 [9] 而只有 3 条证据,意味着答案引用了不存在的东西,比没有引用更糟——用户点进去发现是空的。
抽取式的每个句子都来自某条证据,天然不会悬空;外部 LLM 可能编,所以这一步是必需的。dangling_citations 不是错误码,这一轮仍然成功,但前端必须能提示”这条引用失效了”。
落库
流结束后新开一个 session_scope():
- 没有
session_id就建一条chat_sessions,标题取问题前 80 字; - user 与 assistant 两条消息一起写,中途失败就都不写,避免留下”有提问没有回答”的孤儿会话;
- assistant 行存
citations,回看时知道当时依据了什么。
流式期间不碰数据库。违反这条的后果不是报错,而是 session.execute() 返回的协程永远不会被 await,消息静默丢掉——和”任务表 0 行、worker 干等”是同一种失败形状。
多轮的真实边界
历史窗口只影响生成侧;检索侧的指代扩展只处理”短问题 + 指代词 + 有历史”三条同时成立的情况。超过 24 字说明用户把话说全了,不该加料;没有指代词说明这一句是自足的。宁可漏扩展(回答稍差),也不要错误扩展(把不相关的上文塞进检索,污染召回)。
会话续问时范围不变:单库会话继续单库,多库会话沿用自己创建时的 kb_ids。让范围中途变化,同一段对话前后的召回范围不同,答案会自相矛盾且无法解释。
已知限制
- 默认不做归纳:抽取式只给原句,要总结就得配外部 LLM。
- 没有超时保护:外部 LLM 的 HTTP 客户端有 120 秒超时,但整条 SSE 没有总时长上限;客户端断开后生成器会继续跑到下一个写入点。
- 历史窗口按字符算:中文、英文、代码混排时,4000 字符对应的 token 数差异很大;它只是预算,不是精确的上下文长度。
- 抽取式对提示词不敏感:它不打磨措辞,只保证可核验。